
Gemini 4 Neon: 61 điểm AA Index, giá 3/15 USD mỗi triệu token
Google ra mắt Gemini 4 Neon: 61 điểm Artificial Analysis Intelligence Index, giá 3 USD mỗi triệu token vào, context window 1 triệu token.
Google vừa ra mắt Gemini 4 Neon trong bài công bố ngày 18/11/2026, định vị là model cân bằng giữa suy luận mức frontier và chi phí cho các tác vụ agent chạy dài. Bài gốc do Koray Kavukcuoglu, SVP Google DeepMind kiêm Chief AI Architect của Google, đứng tên. Trên Hacker News, bài lọt front page với 272 điểm và 261 bình luận, tính đến khi bài gốc đăng.
Có gì mới trong Gemini 4 Neon
Theo bài công bố, Neon hướng tới frontier-level intelligence với khả năng hoàn thành tác vụ đầu-cuối nhanh, tập trung vào ba nhóm việc: software engineering phức tạp, knowledge work và quy trình khoa học. Thay vì đua điểm tuyệt đối, Google đặt Neon ở vị trí cân bằng giữa độ sâu suy luận và hiệu quả token.
Các con số chính mà Google nêu:
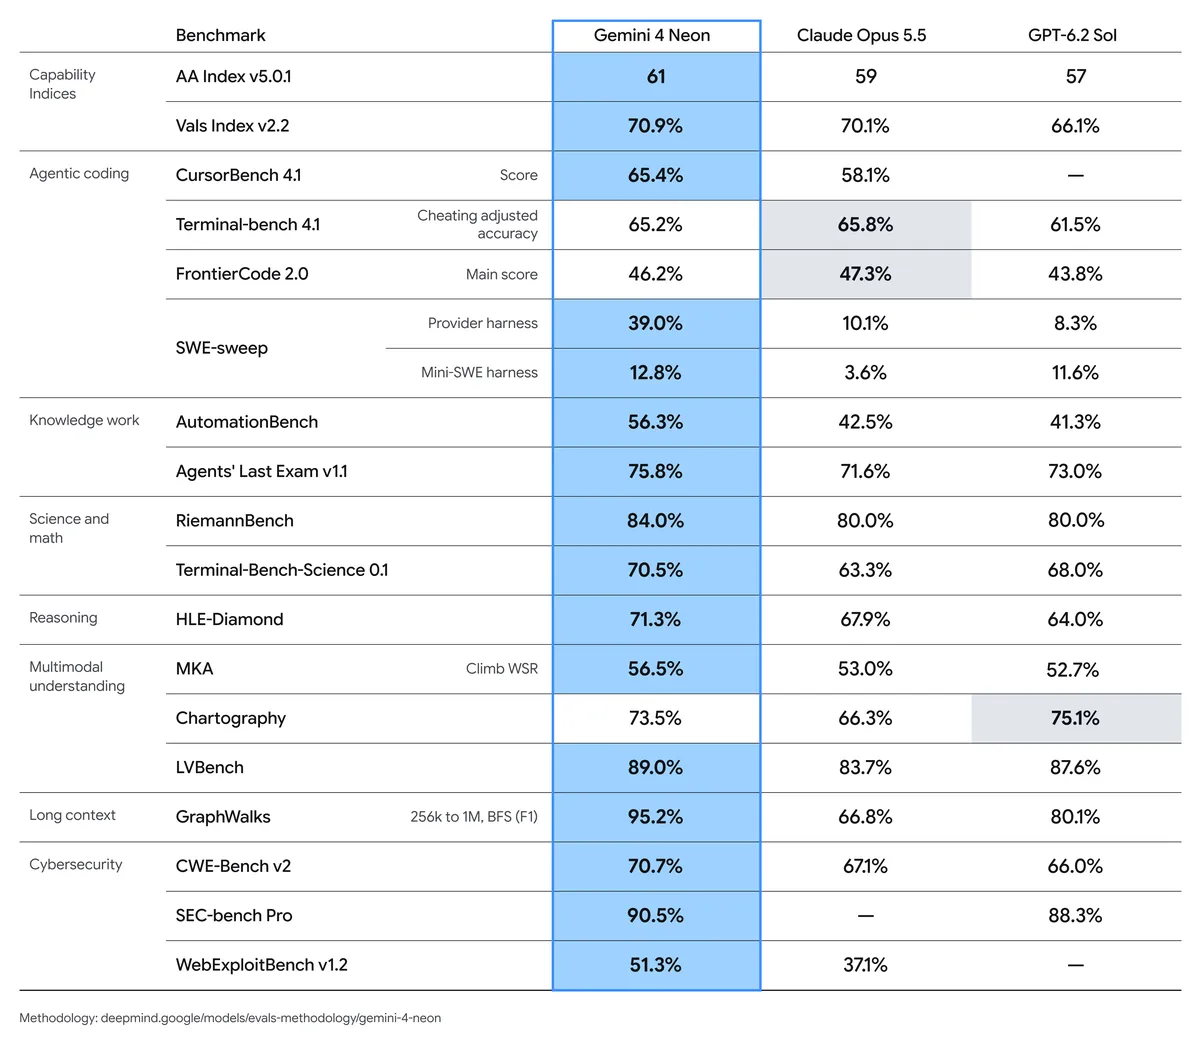
- 61 điểm trên Artificial Analysis Intelligence Index ở mức thinking xhigh, xếp #3 tổng thể, sau các model lớn và chậm hơn.
- #2 trên Vals Index với 70,9%, nằm trên Pareto frontier.
- #2 toàn cầu với 1336 điểm trên Agent Arena Index mới của Arena, đo trên hơn 4.200 phiên agent thực tế; đồng thời xếp #2 về steerability, tức khả năng tiếp nhận chỉnh sửa giữa tác vụ.
- Google cho biết Neon đạt tỉ lệ fabrication (bịa thông tin) thấp nhất từ trước tới nay trong kiểm thử nội bộ trên Google Antigravity.
 Ảnh: Google Blog – Google DeepMind (qua Hacker News)
Về giá và ngữ cảnh: 3 USD / 1 triệu input token, 0,15 USD / 1 triệu cached input token (giảm 95%), 15 USD / 1 triệu output token, context window 1 triệu token. Model có bốn mức thinking, cho phép điều chỉnh giữa độ thông minh và lượng token tiêu thụ.
Hiệu quả chi phí là điểm bán chính
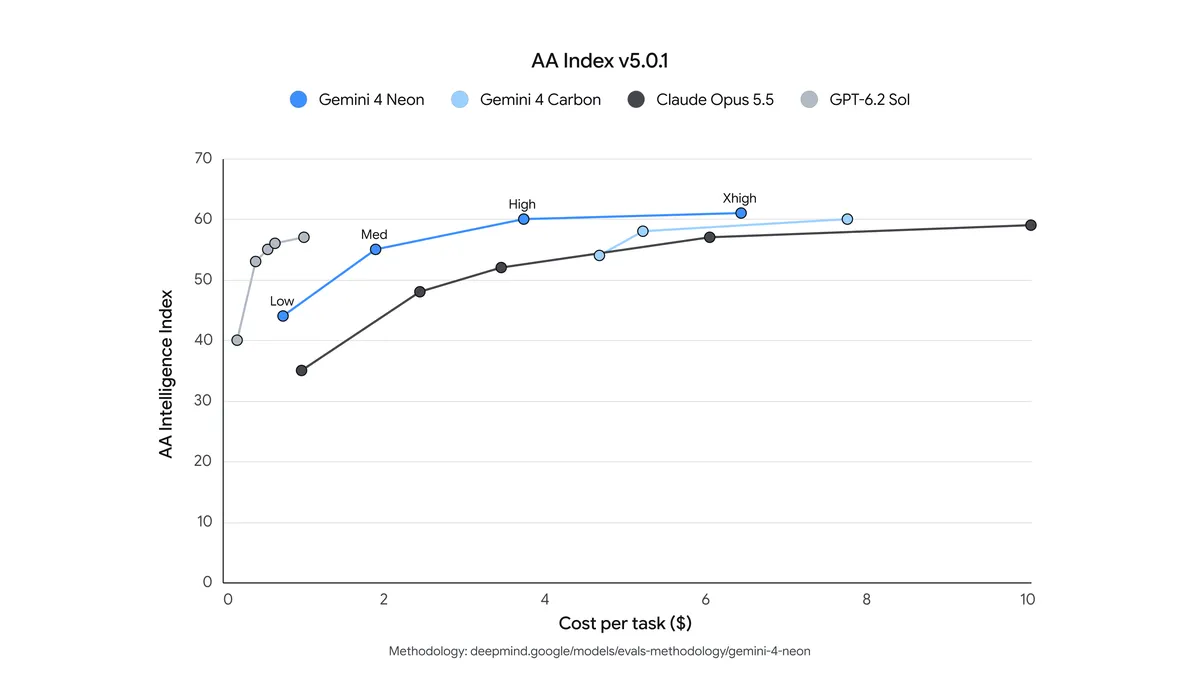
Theo Google, ở mức thinking high mặc định, Neon đạt điểm Intelligence Index cao trên Artificial Analysis kèm chi phí mỗi tác vụ thấp hơn 32% so với Gemini 4 Carbon. Model cũng nằm trên Pareto frontier của cả Vals Index và Agent Arena ở mức high, với chi phí mỗi tác vụ thấp hơn khoảng 50% đến 80% so với các frontier model hàng đầu đang cạnh tranh.
Mức xhigh được thiết kế cho các bài toán engineering, phân tích và khoa học khó nhất. Google nêu Neon đạt điểm thông minh cao nhất ở mức này nhưng vẫn rẻ hơn 36% trở lên tính theo chi phí mỗi tác vụ so với các model đối thủ ở thiết lập cao nhất của chúng.
 Ảnh: Google Blog – Google DeepMind (qua Hacker News)
Đây là điểm đáng chú ý về mặt thiết kế: Google không cố đạt vị trí số 1 về chỉ số thông minh thuần, mà chọn cạnh tranh bằng bài toán chi phí trên mỗi tác vụ hoàn thành. Với người dùng API trả tiền theo token, đây thường là chỉ số ảnh hưởng tới hóa đơn thực tế hơn là điểm benchmark tổng hợp.
Doanh nghiệp, phân tích và khoa học
Google mô tả công việc doanh nghiệp nằm rải rác trong spreadsheet, PDF, chart, audio và video. Neon có thể tổng hợp qua tất cả các loại đầu vào này trong một context window 1 triệu token và biến chúng thành deliverable có cấu trúc.
Theo bài công bố, Neon đạt #1 trên cả Legal Research Bench và Tax Agent Bench. Trên các benchmark của Surge AI, model xếp #1 ở phần lớn hạng mục thuộc finance, accounting, spreadsheet modeling và complex constraint following. Các con số khác được nêu: 73,5% trên Chartography (đọc biểu đồ chuyên nghiệp dày đặc), 75,8% trên Agents' Last Exam v1.1, 56,3% trên AutomationBench của Zapier và #1 trên Vending-Bench 2 của Andon Labs với 16.843 USD — một mô phỏng dài hơi về điều hành doanh nghiệp.
Với suy luận khoa học và toán học, Google nêu Neon dẫn đầu ở Terminal-Bench Science (70,5%), RiemannBench (84,0%) và HLE-Diamond (71,3%).
Coding agent và workflow chạy dài
Theo Google, Neon được thiết kế cho các agent workflow chạy lâu, giữ được hiệu năng qua những tác vụ dùng nhiều tool từ đầu tới cuối. Model có thể chạy độc lập hoặc đóng vai orchestrator điều phối các subagent Hydrogen chạy song song trong Google Antigravity. Google cho biết Neon giảm việc đọc file trùng lặp, chia sẻ tiến độ trong lúc làm và xử lý context compaction ổn định trong các phiên dài.
Các số liệu được nêu: #1 trên Artificial Analysis Coding Agent Index (58,6), 65,2% trên Terminal-Bench 4.1 và 46,2% trên FrontierCode 2.0 ở thiết lập high mặc định. Với mã production, Neon xử lý debug và refactor nhiều file trong repository bằng các chỉnh sửa có mục tiêu, mang tính phẫu thuật. Trên SWE-sweep, model dẫn đầu với harness mini-SWE (12,8%) và tăng hơn gấp ba lần lên 39,0% khi chạy trong Google Antigravity — con số Google dùng để minh họa harness có thể thay đổi kết quả nhiều tới mức nào.
Bài công bố cũng liệt kê bốn demo thực hiện trong Antigravity:
- Điều khiển Blender MCP bằng lệnh /swarm để dựng bàn lab 3D photorealistic mô phỏng tên các model.
- Viết từ đầu một game mô phỏng trượt tuyết WebGL2 góc nhìn thứ nhất trên địa hình thật của Mont Blanc và Chamonix, gồm 10.200 dòng shader tùy biến, vật lý trượt 120 Hz trên sáu tuyến, vết cắt động, tuyết lở và Web Audio không gian, không dùng asset dựng sẵn.
- Dùng /swarm lấy ảnh lưu trữ để tái tạo phòng làm việc năm 1936 của Alan Turing tại King's College, Cambridge dưới dạng 3D tương tác, kèm một Universal Turing Machine hoạt động được trên bàn.
- Biến một ảnh duy nhất thành Google Sheet 100.000 ô không nhúng ảnh, không Apps Script, dùng hơn 500.000 công thức sống để chạy edge detection, dựng bản đồ độ sâu 3D và relight cảnh qua sáu chế độ tương tác.
Mảng cyber: sinh mã an toàn và săn lỗ hổng
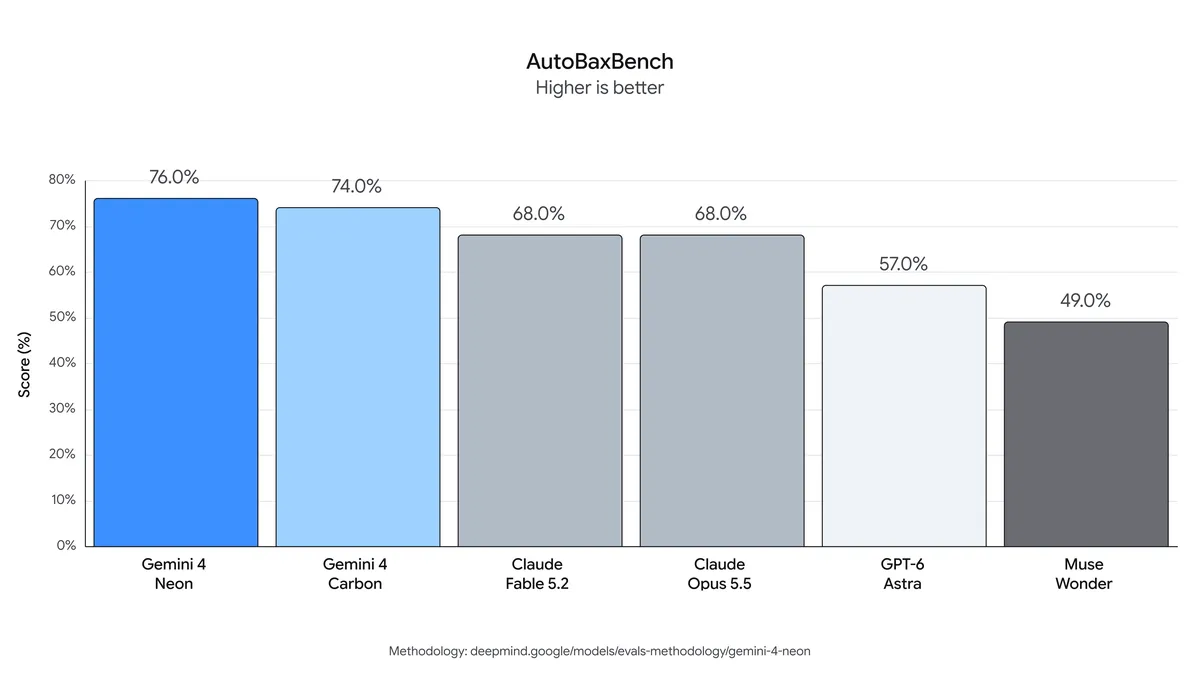
Google giới thiệu thêm biến thể Gemini 4 Neon for cyber. Theo bài công bố, model tạo ra mã an toàn hơn Carbon ở toàn bộ các mức dễ, trung bình và khó trên AutoBaxBench, đạt state-of-the-art ở mức khó với 76%.
 Ảnh: Google Blog – Google DeepMind (qua Hacker News)
Trên WebExploitBench v1.2, Google nêu Neon đạt state-of-the-art 51,26% với chi phí bằng một nửa các model lớn đang cạnh tranh. Với vòng đời hardening mã nguồn, các số liệu được đưa ra gồm:
- Tìm lỗ hổng: state-of-the-art trên SEC-bench Pro (90,5%), chi phí mỗi challenge khoảng một nửa.
- Xác thực rủi ro bằng khai thác: hiệu năng mức frontier trên ExploitGym, dùng một nửa token so với Carbon.
- Vá lỗ hổng: 70,7% trên CWE-bench v2 của Collinear, tăng 3,4% so với Carbon.
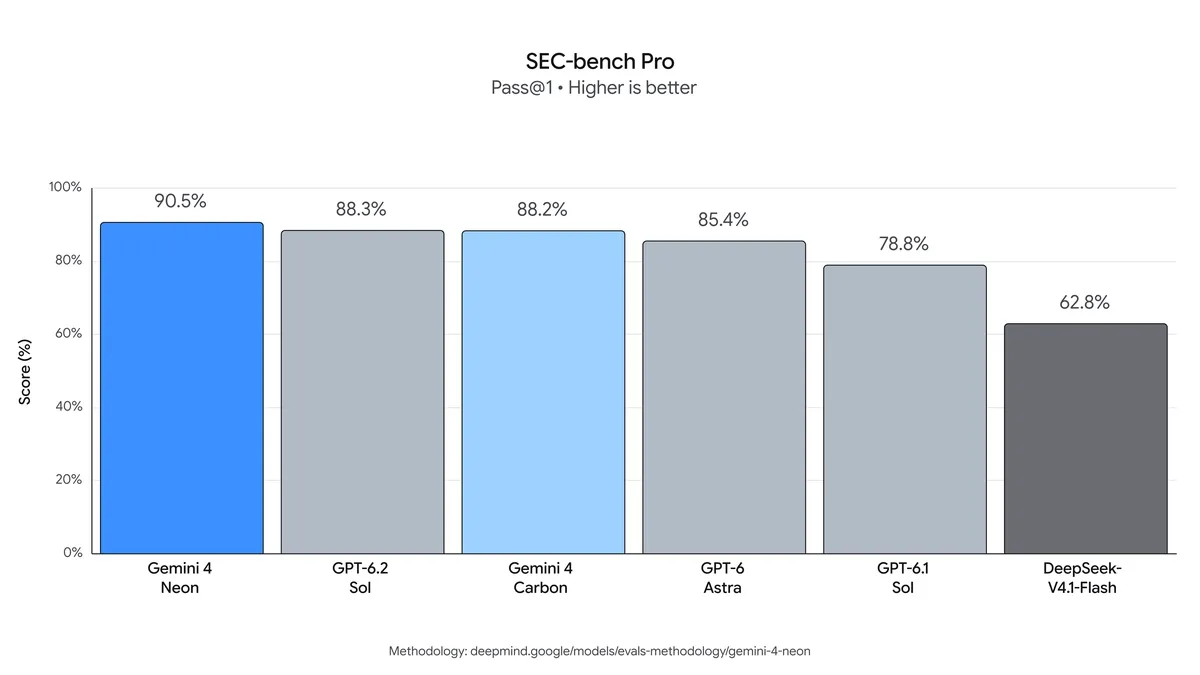 Ảnh: Google Blog – Google DeepMind (qua Hacker News)
Biến thể cyber này sẽ được cấp cho các defender đủ điều kiện trong chương trình Fairwind Program trong vài ngày tới, theo bài gốc.
An toàn và hành vi agent
Google nêu Neon kế thừa stack an toàn của Gemini 4, giữ mức bảo vệ tương đương Carbon trước lạm dụng nghiêm trọng và prompt injection, đồng thời cải thiện thêm về alignment và hành vi agent.
Một số chỉ số nội bộ được công bố: mức từ chối 1,98% tác vụ trên Terminal-Bench 4.0 và 0% trên Terminal-Bench-Science; 0,0% gian lận trên Terminal-Bench 4.0, tỉ lệ đi đường tắt 2,45% trên bài đánh giá coding cheating; tỉ lệ hành động lệch hướng 0,09% trên bộ kiểm thử agentic safety và tỉ lệ đạt 99,2% trên bài đánh giá agent honesty. Google cho biết Neon giảm under-service từ 43% đến 56% và giảm overreach từ 15% đến 35% ở các mức effort khác nhau so với baseline của Carbon.
Trên benchmark IPI của Gray Swan, Google cho biết với real-time safeguards ở mức thinking cao nhất, Neon chống được toàn bộ các cuộc tấn công trong benchmark này, tương đương tỉ lệ thành công 0,0%.
Neon nằm ở đâu trong gia đình Gemini 4
Theo cách Google phân chia, Carbon dành cho các dự án khó nhất, chạy dài hơi; Hydrogen xử lý nhanh các tác vụ thường ngày; Neon cân bằng giữa độ sâu và hiệu quả, phục vụ các workflow phức tạp nhưng tần suất cao, cần suy luận mức frontier với chi phí thấp hơn.
Ai nên dùng và cách bắt đầu
Theo bài gốc, Neon bắt đầu roll out ngay trong ngày công bố:
- Lập trình viên: dùng Gemini API ở paid tier trong Google AI Studio và Android Studio; nếu là subscriber trả tiền của Google AI Pro hoặc Ultra, có thể thử trong Google Antigravity; mọi subscriber Pro và Ultra đều có thể thử trong AI Studio.
- Doanh nghiệp: dùng Gemini 4 Neon trong Gemini for business qua API hoặc model drop-down, và trong Google Antigravity.
- Người dùng cuối: subscriber Google AI Pro hoặc Ultra chọn Gemini 4 Neon từ model drop-down trong ứng dụng Gemini.
- Đội cyber: thành viên Fairwind Program đủ điều kiện sẽ nhận quyền truy cập trong vài ngày tới; muốn xin quyền, liên hệ đội Cloud account.
Với độc giả làm kỹ thuật, điểm đáng thử trước là các tác vụ refactor và debug nhiều file, hoặc những job agent chạy dài cần theo dõi tiến độ và context compaction. Cách kiểm tra thực tế nhất là chạy cùng một tác vụ trên Neon ở mức high và xhigh, rồi so chi phí mỗi tác vụ hoàn thành với model đang dùng, thay vì chỉ so điểm benchmark.
Lưu ý và hạn chế
- Đây là bài công bố trên blog sản phẩm của chính Google, nên các so sánh và con số cần được đọc với tinh thần đó.
- Phần lớn benchmark trong bài do Google công bố; một số bài đo chạy trên harness hoặc môi trường nội bộ như Google Antigravity, nên kết quả có thể phụ thuộc mạnh vào harness — chính Google thừa nhận điều này khi nêu chênh lệch giữa mini-SWE harness và Antigravity trên SWE-sweep.
- Các chỉ số an toàn như 0,0% attack success rate trên Gray Swan IPI gắn với cấu hình có real-time safeguards ở mức thinking cao nhất, không phải mọi cấu hình triển khai.
- Bài gốc chưa nêu chi tiết về phần cứng hay hạ tầng phục vụ, về việc có mở trọng số hay không, cũng chưa nêu breaking change nào cho người đang dùng API. Thời điểm phổ cập đầy đủ và mốc kết thúc roll out cũng chưa được nêu.
- Một số hạng mục như điểm trên Vals Index hay Agent Arena Index lấy theo thời điểm bài gốc đăng; các bảng xếp hạng này cập nhật thường xuyên nên vị trí có thể thay đổi.
Kết
Gemini 4 Neon không phải một model nhằm soán ngôi đầu bảng chỉ số thông minh. Điểm đáng chú ý nằm ở việc Google chọn đánh vào chi phí mỗi tác vụ, độ ổn định khi chạy agent dài và một biến thể cyber riêng — những yếu tố ảnh hưởng trực tiếp tới hóa đơn và độ tin cậy khi đưa vào pipeline production. Nếu mức giá và context window 1 triệu token đúng như công bố, đây là lựa chọn đáng đưa vào danh sách thử nghiệm cho các nhóm kỹ thuật đang tối ưu chi phí agent.
Nguồn tham khảo: Google Blog – Google DeepMind (qua Hacker News)
Bài viết liên quan
AI cho lập trình viên11 phút đọc
Chạy GLM-5.3 753 tỷ tham số trên hai DGX Station với vLLM
NVIDIA hướng dẫn chạy GLM-5.3 753 tỷ tham số trên hai DGX Station bằng vLLM với tensor parallelism TP=2, đạt 607,8 tok/s và toàn bộ trọng số nằm trong GPU.
AI cho lập trình viên8 phút đọc
learn-claude-code: repo dạy tự xây agent harness từ 0
Repo Python của shareAI-lab dạy cách tự viết harness cho coding agent: tools, knowledge, observation, quyền hạn. Tính đến 15/11/2026, repo đạt 80.412 sao.
AI cho lập trình viên7 phút đọc
Đánh giá 22 coding agent harness: 64,5% chi phí suy luận đổ vào các lần chạy thất bại
FrontierHarness Eval v1.1 chạy 27.280 lần thử với 22 harness và 5 model, phát hiện mỗi model có harness tối ưu chi phí khác nhau và phần lớn chi phí đến từ các lần chạy không đạt.
Bình luận
Đang tải bình luận…