
Chạy GLM-5.3 753 tỷ tham số trên hai DGX Station với vLLM
NVIDIA hướng dẫn chạy GLM-5.3 753 tỷ tham số trên hai DGX Station bằng vLLM với tensor parallelism TP=2, đạt 607,8 tok/s và toàn bộ trọng số nằm trong GPU.
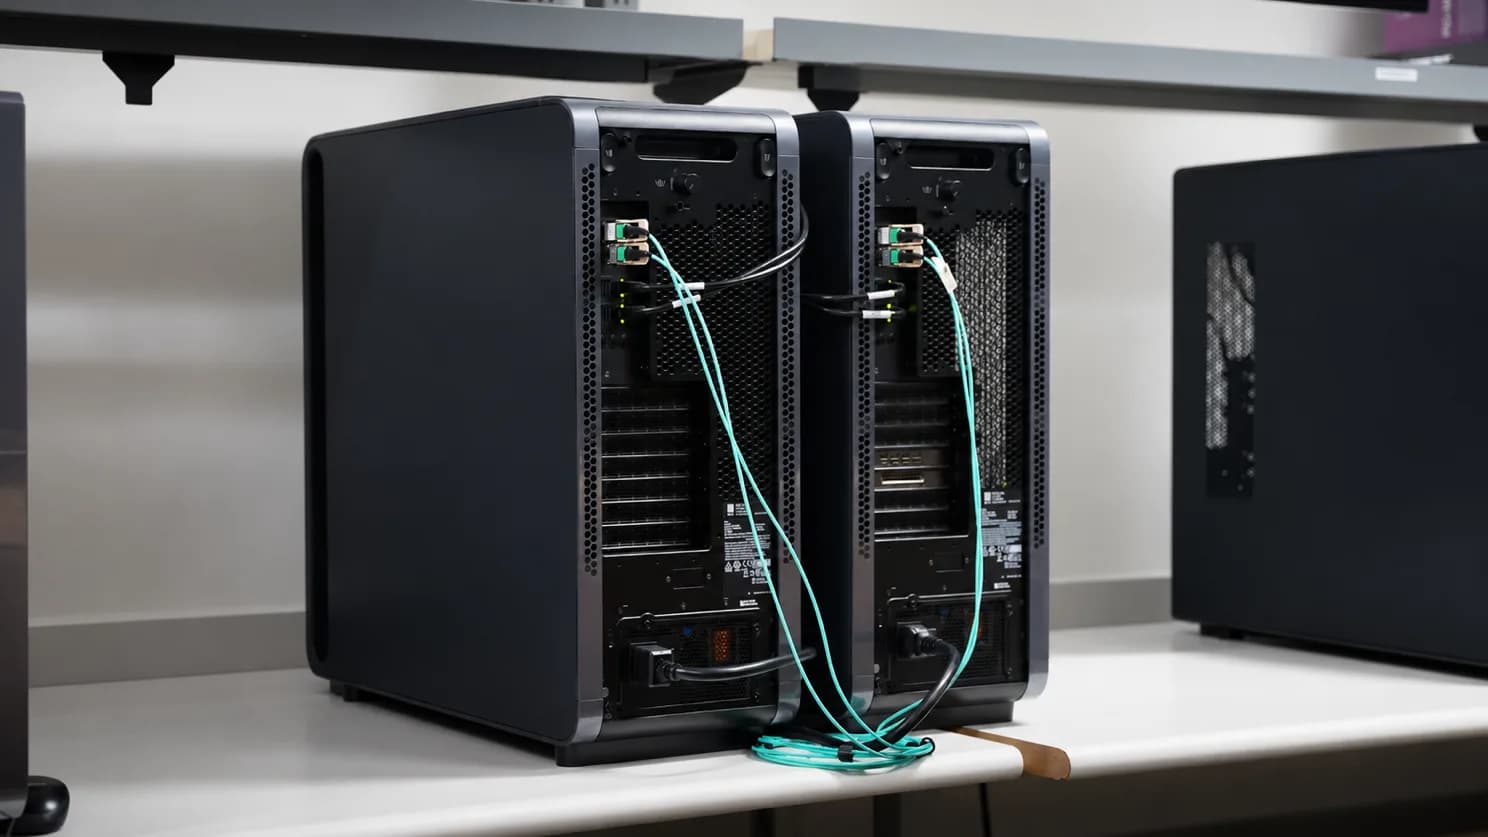
NVIDIA vừa công bố hướng dẫn phục vụ GLM-5.3 — mô hình MoE 753 tỷ tham số của Z.ai — trên hai máy DGX Station nối với nhau bằng ConnectX-8 RDMA, dùng vLLM với tensor parallelism TP=2 và trả về qua một endpoint tương thích OpenAI. Điểm đáng chú ý không nằm ở con số 607,8 tok/s, mà ở chỗ toàn bộ trọng số nằm trong GPU, không offload xuống CPU, và cả hệ thống chỉ gồm hai máy đặt tại chỗ. Với những nhóm buộc phải giữ dữ liệu trong nội bộ, đây là một mẫu tham chiếu khá chi tiết để đọc và mổ xẻ.
Vì sao một GPU là không đủ
Theo bài gốc trên NVIDIA Developer Blog, checkpoint của GLM-5.3 NVFP4 nặng khoảng 464 GB, trong khi một GPU GB300 chỉ có 252 GB HBM3e. Mô hình có 753 tỷ tham số nhưng chỉ kích hoạt khoảng 40 tỷ tham số mỗi token nhờ kiến trúc MoE — nghĩa là chi phí tính toán mỗi token không tỷ lệ với tổng số tham số, song toàn bộ trọng số vẫn phải thường trú trong bộ nhớ GPU.
Đó là lý do phải dùng hai máy. Bài viết nói rõ một quyết định thiết kế: tắt hoàn toàn cơ chế offload trọng số xuống CPU. Offload giúp mô hình vừa hơn về mặt bộ nhớ nhưng kéo theo độ trễ và băng thông PCIe, nên hướng dẫn này chọn chia mô hình ra hai GPU và chấp nhận chi phí truyền thông giữa hai máy.
Kiến trúc hai trạm
Station A giữ vai rank 0, chạy API server; Station B là rank 1, chạy worker ở chế độ headless. Mỗi request đều được cả hai GPU cùng tính, các kết quả trung gian trao đổi qua rail RoCE. Bộ nhớ của hai máy vẫn tách biệt hoàn toàn — không có chuyện gộp thành một pool chung.
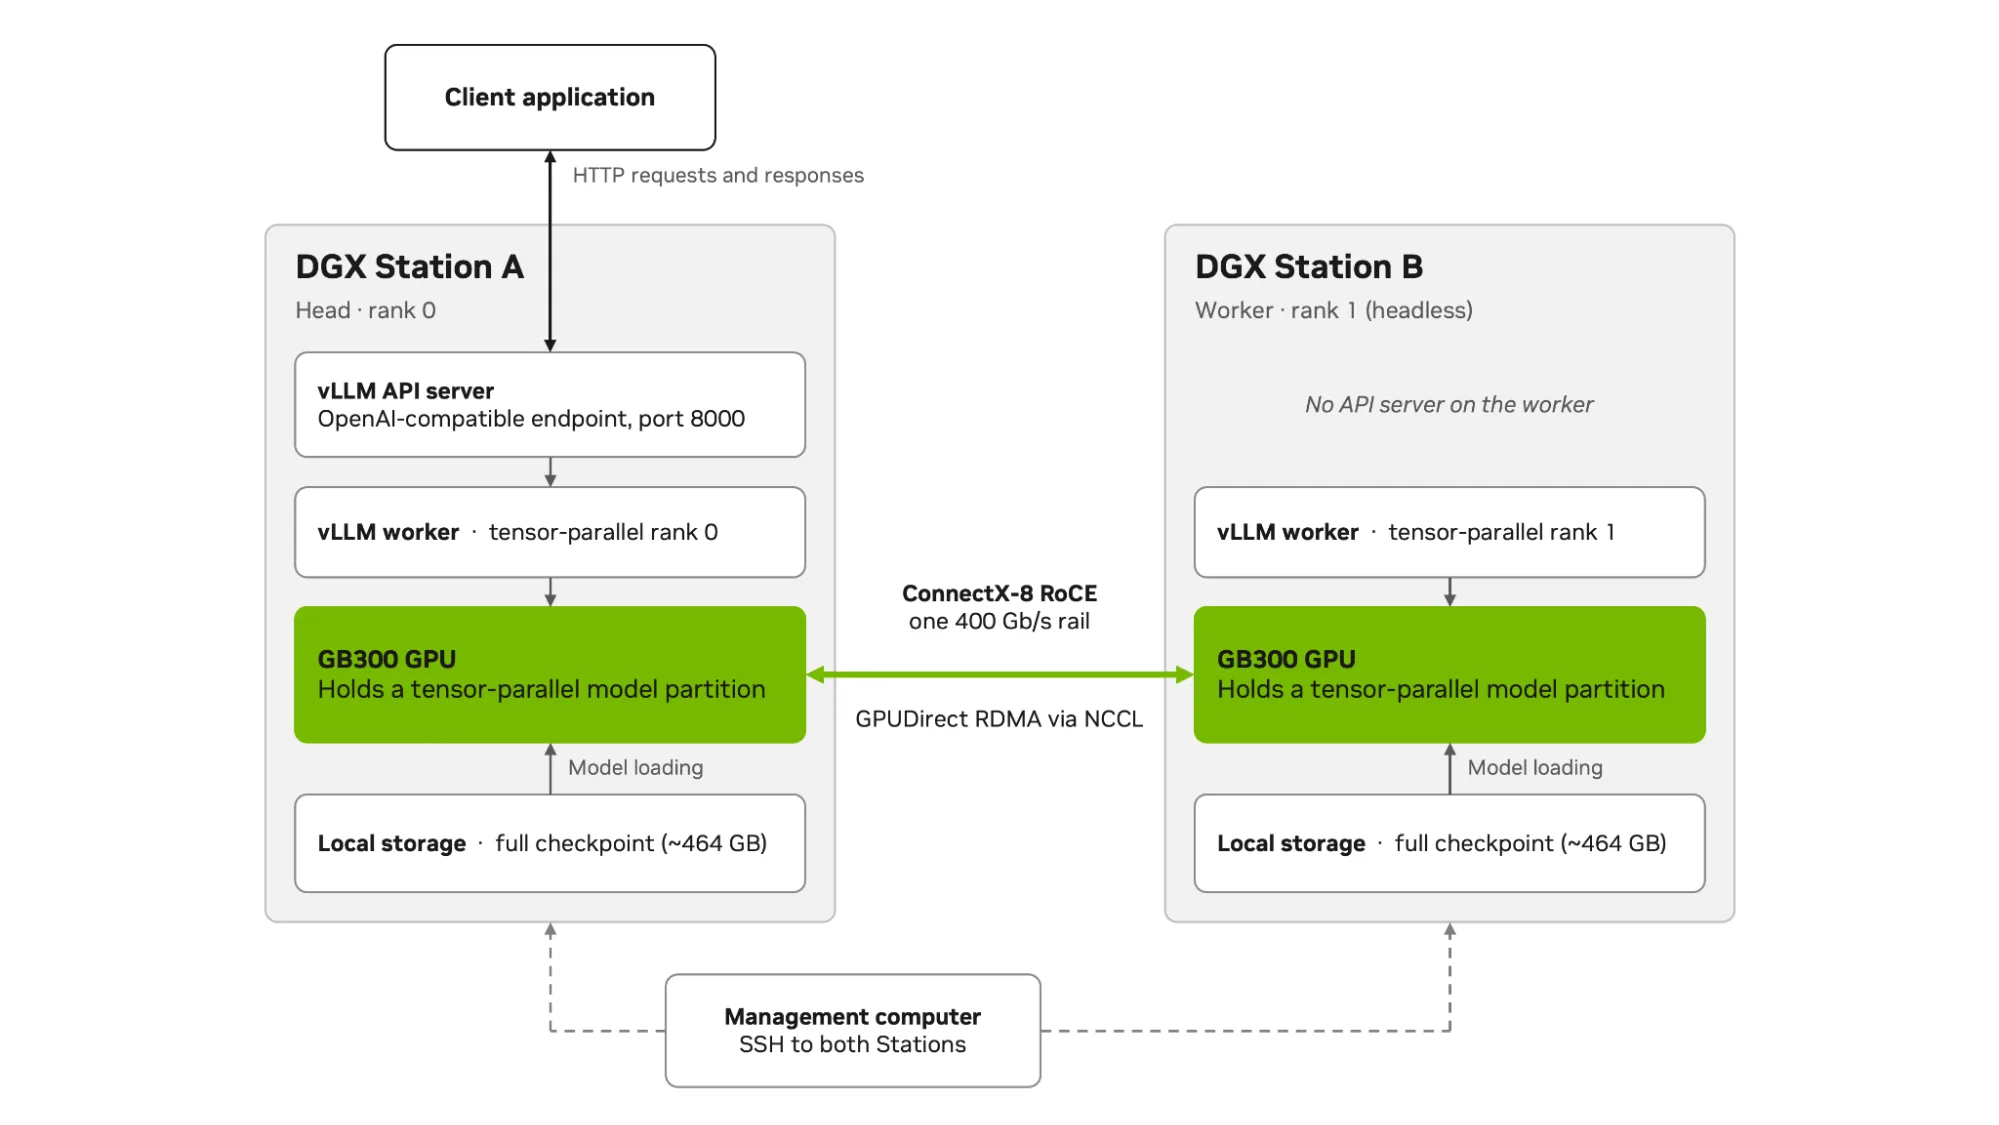 Ảnh: NVIDIA Developer Blog (qua Hacker News)
Một điểm đáng chú ý về vận hành: bài gốc không đưa ra một lệnh chạy duy nhất, mà mô tả quy trình bốn bước có kiểm chứng ở từng mốc, kèm cảnh báo bảo mật riêng.
Điều kiện tiên quyết
Hướng dẫn yêu cầu hai GB300 DGX Station đã được nối và kiểm chứng bằng playbook Connect Two DGX Stations, bao gồm bài test RDMA trực tiếp trên GPU memory ở cả hai rail. Ngoài ra cần: SSH và sudo dùng cùng username trên hai máy, Docker cùng NVIDIA Container Toolkit, quyền truy cập registry và Hugging Face và kho package, tối thiểu 464 GB đĩa trống trên mỗi máy, chấp nhận NVIDIA Open Model Agreement cùng license của GLM-5.3, và một token Hugging Face có quyền vào dataset gated cais/hle phục vụ SPEED-Bench.
Có thể thấy ngay đây không phải bài hướng dẫn cho người dùng phổ thông. Đây là tài liệu cho kỹ sư hạ tầng đã có phần cứng trong tay.
Bước 1 và 2: cấu hình rail và đồng bộ checkpoint
Bước đầu tiên là thu thập thông tin mạng: docker version, ibdev2netdev và ip -br addr để lấy tên rail (ví dụ cx8r0/cx8r1), RDMA device (như mlx5_1) và địa chỉ IPv4. Các giá trị này được ghi vào file ~/glm53.env gồm RANK, HEAD_IP, WORKER_IP, RAIL_IFACE, RAIL_HCA, image đã ghim vllm/vllm-openai:v0.30.0-aarch64 kèm digest, MODEL_REPO/MODEL_REV, MODEL_HOST, CONTAINER và PORT 8000.
Trước khi chạy, bài gốc kiểm tra đường truyền: link 400000 Mb/s, MTU 9000, ping jumbo với -s 8972, NTP đồng bộ, và nvidia-smi không còn tiến trình compute nào. Sau đó tạo SSH key ed25519 không passphrase để máy A đăng nhập máy B mà không cần mật khẩu.
Bước 2 là pull image trên cả hai máy rồi so digest arm64, tải checkpoint trên A (khoảng một giờ ở 1 Gb/s, khoảng sáu phút ở 10 Gb/s), rsync sang B có loại trừ .cache, rồi đối chiếu sha256 danh sách tên và kích thước file. Phần kiểm tra yêu cầu đếm đủ 50 shard safetensors và assert kiến trúc GlmMoeDsaForCausalLM cùng quant_algo là MIXED_PRECISION trước khi báo MODEL_READY. Đây là kiểu kiểm tra đáng học theo: thiếu một shard vẫn có thể tải xong, nhưng mô hình sẽ hỏng ở bước khởi động và rất khó lần ra nguyên nhân.
Bước 3: khởi động vLLM với TP=2
Cùng một script launch-glm53.sh được chạy trên cả hai máy. Script bật MTP speculative decoding với 4 token nháp mỗi bước, KV cache FP8, prefix caching, --max-model-len 98304, --gpu-memory-utilization 0.93, tìm GID index RoCE bằng show_gids và truyền một loạt biến NCCL (NCCL_IB_HCA, NCCL_IB_GID_INDEX, timeout 22, retry 7).
Script cố ý dùng NCCL 2.30.7 có trong image, vì các bản cũ hơn có thể deadlock khi replay CUDA graph liên node qua RoCE (bài gốc dẫn vLLM issue #52504). Thứ tự chạy là B trước rồi tới A; sau đó chờ log báo Application startup complete và đọc GPU KV cache size trong log để biết sức chứa context dùng chung giữa hai trạm.
Một chi tiết dễ bị bỏ qua nhưng quan trọng: --host 0.0.0.0 kết hợp --network host sẽ phơi API chưa xác thực trên mọi interface của Station A. Bài gốc khuyến nghị thêm firewall, TLS và authentication trước khi mở rộng quyền truy cập.
Bước 4: xác minh RDMA thật sự hoạt động
Gọi /health trong container để thấy HEALTH_OK là chưa đủ. Bước quan trọng hơn là kiểm tra hai rank có thật sự giao tiếp qua GPU RDMA hay đang âm thầm fallback về TCP socket — chuyện này vẫn cho ra kết quả đúng nhưng chậm hơn nhiều, và rất khó phát hiện nếu chỉ nhìn đáp án của mô hình. Cách làm trong bài là đọc log NCCL mà launcher ghi ra với NCCL_DEBUG=INFO, và chỉ in RDMA_CHECK_OK khi không có cảnh báo NET/Socket, không có NCCL WARN hay NCCL ERROR.
nvidia-smi trên A và B cho thấy mỗi GPU chạy một rank VLLM::Worker_TP0/TP1, log báo khoảng 218 GiB trọng số mỗi GPU, xác nhận mô hình được chia đôi giữa hai máy. Bảng 1 trong bài so sánh bộ nhớ GPU trước và sau khi nạp model: từ gần 0 lên khoảng 231,3 GiB trên cả hai trạm, bao gồm trọng số, KV cache và buffer runtime.
Sau đó bài gửi thử một chat request qua API tương thích OpenAI trên trạm A với temperature=0, max_tokens=4096 và reasoning_effort=low; kết quả trả về finish_reason: stop. GLM-5.3 nhận ba mức reasoning_effort gồm low, high và max; mức cao cho model suy luận lâu hơn nhưng đổi lại độ trễ lớn hơn. Launcher cũng bật --enable-auto-tool-choice, nên các agent framework dùng OpenAI tools API có thể gọi cùng endpoint đó.
Đo hiệu năng: 607,8 tok/s ở concurrency 16
Phần benchmark dùng AIPerf 0.12.0, được cài riêng trong virtualenv để không làm thay đổi dependency của vLLM — bước cài kết thúc bằng No broken requirements found. Bộ đo là 80 hội thoại Coding của SPEED-Bench, tổng 89 lượt, và cần đồng ý truy cập dataset có gate cais/hle trên Hugging Face trước khi chuẩn bị dữ liệu.
Lần quét đầy đủ chạy ở concurrency 1, 8, 16 và 32. Mỗi mức gửi 3×C request warmup rồi đo 10×C request, dùng reasoning effort mặc định là max và giới hạn 8192 token đầu ra. Bài cũng đưa một lệnh rút gọn chỉ chạy C1 và C8 với prefix caching, timeout request 7200 giây, thu server-metrics để đo tỉ lệ chấp nhận MTP và export-level raw để giữ từng phản hồi.
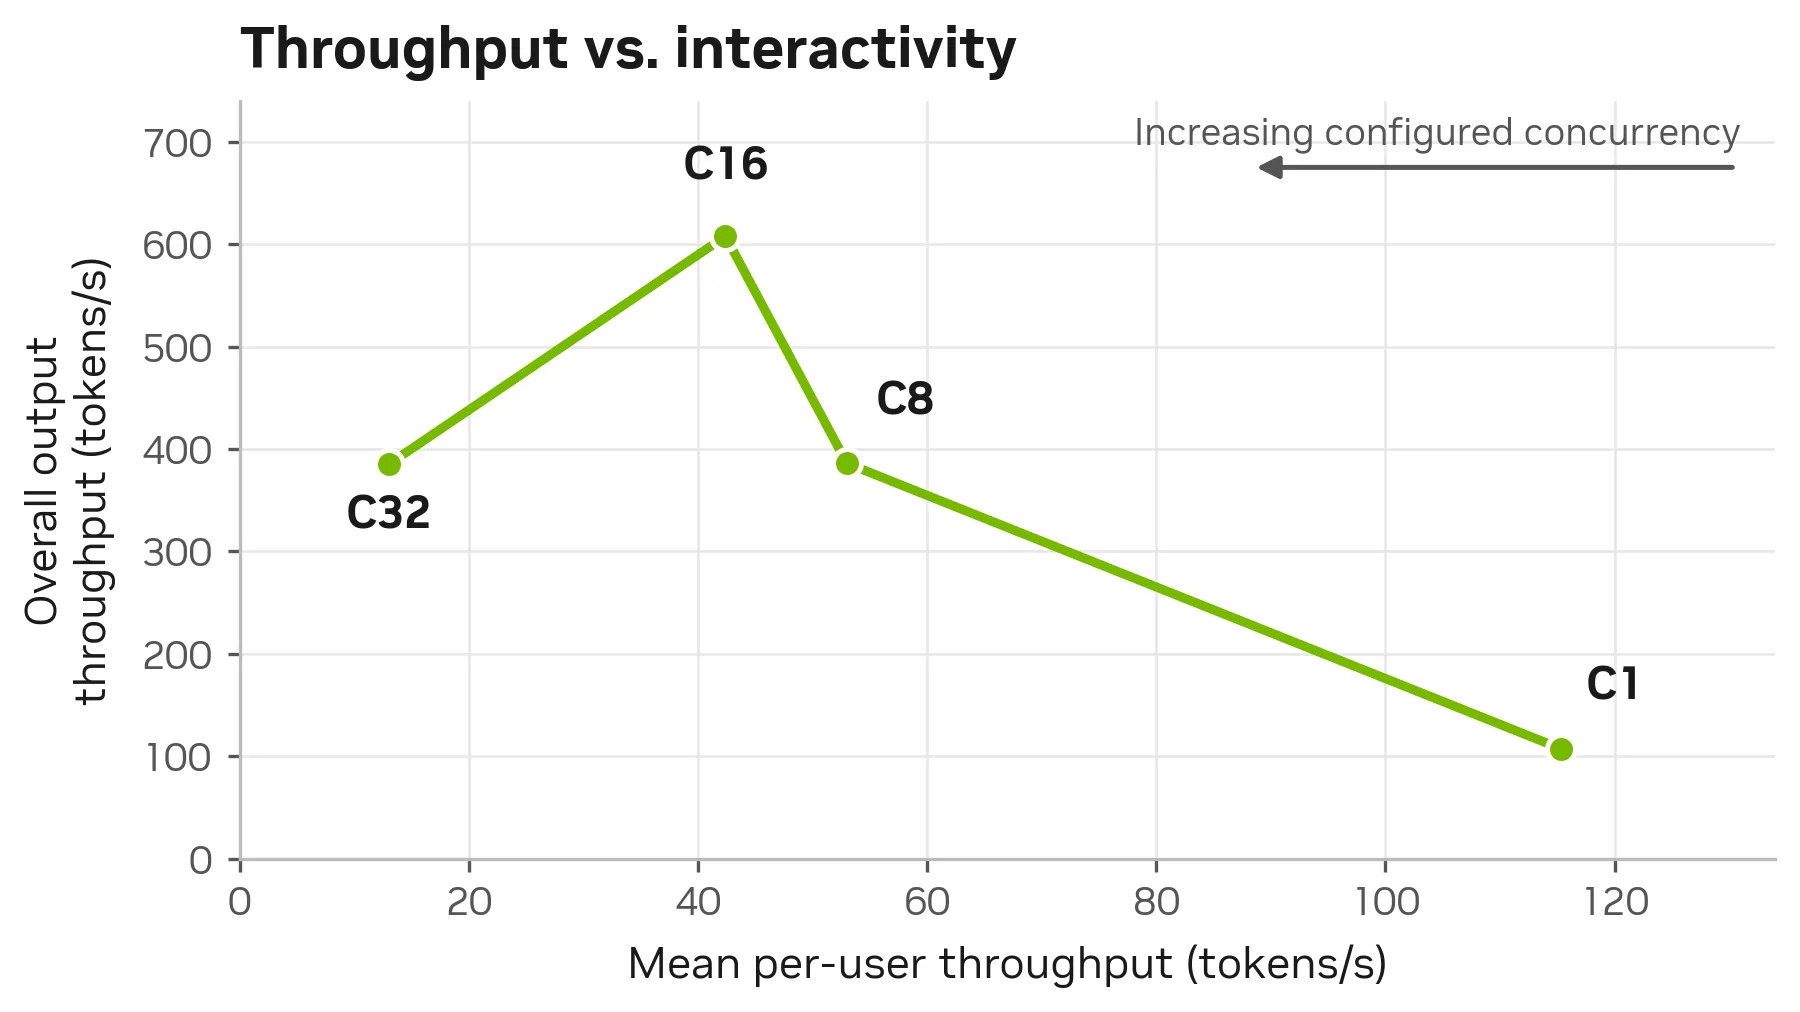 Ảnh: NVIDIA Developer Blog (qua Hacker News)
Kết quả: thông lượng tổng đạt đỉnh 607,8 tok/s ở C16 rồi giảm còn 385,0 tok/s ở C32, nơi độ trễ trung bình mỗi request lên tới 453,5 giây. Thông lượng trung bình mỗi người dùng giảm từ 115,3 tok/s ở C1 xuống 13,0 tok/s ở C32. Đây là minh hoạ khá rõ cho đánh đổi giữa tải tổng và trải nghiệm từng người: tăng concurrency không đồng nghĩa hệ thống phục vụ tốt hơn, và ở mức C32 thì kết quả đi theo hướng ngược lại.
Dừng và khởi động lại
Dừng container vLLM trên A rồi tới B bằng docker stop --timeout 60; trạng thái phải là Status=exited và Running=false, đồng thời không còn tiến trình vLLM trong nvidia-smi. Có thể khởi động lại bằng docker start trên B rồi A và lặp lại các bước kiểm tra của Step 4; checkpoint, container và kết quả vẫn nằm trên đĩa nên không phải tải lại.
Bài gốc cũng liệt kê các lỗi thường gặp: thiếu biến môi trường hoặc lỗi SSH, lỗi dataset có gate, lỗi khởi động hay RDMA, và CUDA out of memory thì giảm --max-model-len hoặc giảm concurrency.
Vì sao đáng quan tâm với lập trình viên Việt Nam
Với góc nhìn của chuyên mục AI cho lập trình viên, giá trị của bài này không nằm ở phần cứng mà ở quy trình. Có ba thứ có thể áp dụng cho bất kỳ ai đang tự phục vụ mô hình lớn:
Thứ nhất là cách kiểm chứng đường truyền và kiểm chứng RDMA trước khi kết luận hệ thống chạy đúng. Rất nhiều lỗi hiệu năng trong cụm GPU bắt nguồn từ việc fallback âm thầm về TCP, và một biến NCCL_IB_GID_INDEX sai có thể khiến mọi con số benchmark trở nên vô nghĩa.
Thứ hai là cách đọc số liệu theo hai trục. Bảng 2 trong bài không chỉ báo thông lượng tổng mà còn báo thông lượng trung bình mỗi người dùng và độ trễ trung bình — bộ ba này mới cho biết hệ thống có thật sự phục vụ được người dùng cuối hay không. Đây là thói quen nên mang sang mọi lần đánh giá vLLM, TGI hay bất kỳ inference server nào.
Thứ ba là chuyện dữ liệu nhạy cảm. Nếu tổ chức có yêu cầu không được gửi dữ liệu ra API bên ngoài, một mô hình 753 tỷ tham số chạy sau endpoint nội bộ trên hai trạm là phương án đáng cân nhắc về mặt kỹ thuật. Nhưng chi phí phần cứng và điện năng là bài toán riêng mà nguồn chưa nêu.
Ai nên dùng, và thử nhanh thế nào
Đối tượng chính của hướng dẫn là đội hạ tầng đã có sẵn hai GB300 DGX Station. Với nhóm này, trình tự hợp lý là: chạy playbook kiểm chứng kết nối trước, kiểm tra link speed và MTU, rồi mới tới bước cấu hình ~/glm53.env. Đừng bỏ qua bước so digest và sha256 file shard — đó là bước rẻ nhất để tránh hàng giờ debug sau đó.
Nếu bạn không có đúng cấu hình phần cứng này, bài vẫn dùng được như tài liệu tham chiếu: cách đặt các biến NCCL cho RoCE, cách bật MTP speculative decoding và KV cache FP8 trong vLLM, cách dùng AIPerf trong virtualenv riêng để không phá dependency, và cách kiểm tra nvidia-smi để xem mỗi rank thực sự đang giữ bao nhiêu trọng số. Nguồn chưa nêu kết quả khi chạy trên số GPU khác, trên GPU khác dòng, hay trên một máy duy nhất, nên không nên sao chép các con số sang cấu hình khác.
Lưu ý và hạn chế
Bài gốc là bài đăng trên blog của chính NVIDIA, công ty bán DGX Station, GPU GB300 và cũng là đơn vị công bố hướng dẫn này. Các con số hiệu năng và lựa chọn cấu hình vì vậy nên được đọc trong bối cảnh đó.
Về bảo mật, cảnh báo trong bài rất cụ thể: khi bật --host 0.0.0.0 cùng --network host, API không có xác thực sẽ lộ trên mọi interface của Station A. Cần firewall, TLS và authentication trước khi cho máy khác truy cập.
Về tính ổn định, việc ghim NCCL 2.30.7 và image theo digest cho thấy cấu hình này khá nhạy với phiên bản. Nâng cấp vLLM hay NCCL mà không chạy lại các bước kiểm chứng có thể dẫn tới deadlock hoặc fallback TCP.
Về thông tin chưa có, nguồn chưa nêu giá, mức tiêu thụ điện, điều kiện nhiệt độ hay độ ồn của hai trạm khi chạy liên tục; cũng chưa nêu kết quả trên các mô hình khác ngoài GLM-5.3 NVFP4.
Kết
Theo bài gốc, GLM-5.3 với 753 tỷ tham số có thể chạy sau một API cục bộ trên hai NVIDIA DGX Station, toàn bộ trọng số nằm trong GPU, không offload xuống CPU. Cấu hình này hướng tới hai tình huống: suy luận trên dữ liệu nhạy cảm cần giữ trong nội bộ, và thử nghiệm agent tại chỗ với endpoint tương thích OpenAI. Phần giá trị nhất cho người làm kỹ thuật có lẽ không phải con số 607,8 tok/s, mà là bộ checklist kiểm chứng từ link, MTU, RDMA, số shard cho tới cách đọc thông lượng theo từng người dùng.
Nguồn: NVIDIA Developer Blog – Serving GLM-5.3 at 607.8 tok/s across two Nvidia DGX stations with vLLM
Nguồn tham khảo: NVIDIA Developer Blog (qua Hacker News)
Bài viết liên quan
AI cho lập trình viên8 phút đọc
learn-claude-code: repo dạy tự xây agent harness từ 0
Repo Python của shareAI-lab dạy cách tự viết harness cho coding agent: tools, knowledge, observation, quyền hạn. Tính đến 15/11/2026, repo đạt 80.412 sao.
AI cho lập trình viên10 phút đọc
Gemini 4 Neon: 61 điểm AA Index, giá 3/15 USD mỗi triệu token
Google ra mắt Gemini 4 Neon: 61 điểm Artificial Analysis Intelligence Index, giá 3 USD mỗi triệu token vào, context window 1 triệu token.
AI cho lập trình viên7 phút đọc
Đánh giá 22 coding agent harness: 64,5% chi phí suy luận đổ vào các lần chạy thất bại
FrontierHarness Eval v1.1 chạy 27.280 lần thử với 22 harness và 5 model, phát hiện mỗi model có harness tối ưu chi phí khác nhau và phần lớn chi phí đến từ các lần chạy không đạt.
Bình luận
Đang tải bình luận…