
Đánh giá 22 coding agent harness: 64,5% chi phí suy luận đổ vào các lần chạy thất bại
FrontierHarness Eval v1.1 chạy 27.280 lần thử với 22 harness và 5 model, phát hiện mỗi model có harness tối ưu chi phí khác nhau và phần lớn chi phí đến từ các lần chạy không đạt.
Khi bạn đổi model cho coding agent, liệu có nên đổi luôn harness? Đó là câu hỏi mà nhóm Runta cùng Baseten muốn trả lời qua FrontierHarness Eval v1.1, benchmark quy mô lớn nhất từ trước đến nay cho các coding agent harness. Với 27.280 lần chạy, 22 harness, 5 model và 62 tác vụ, kết quả cho thấy không có harness nào là tốt nhất cho mọi model, và đáng chú ý: 64,5% chi phí suy luận đã đổ vào những lần chạy thất bại.
Có gì mới trong FrontierHarness Eval v1.1
Phiên bản trước (v1.0) chỉ chạy 9 harness với một model duy nhất là Kimi K3. Lần này, nhóm nghiên cứu đã mở rộng lên 22 cấu hình harness (bao gồm 18 harness, trong đó có 4 cấu hình DeepSeek Harness với bộ công cụ khác nhau và 2 phiên bản OpenCode) và 5 model mã nguồn mở được phục vụ bởi Baseten: GLM-5.3, GLM-5.3 Flash, DeepSeek-V4.1-Flash-1017, Muse và Kimi-K3. Mỗi cặp harness-model chạy 62 tác vụ terminal, lặp lại 4 lần để giảm nhiễu, tổng cộng 27.280 lần chạy và tiêu tốn 83 tỷ token.
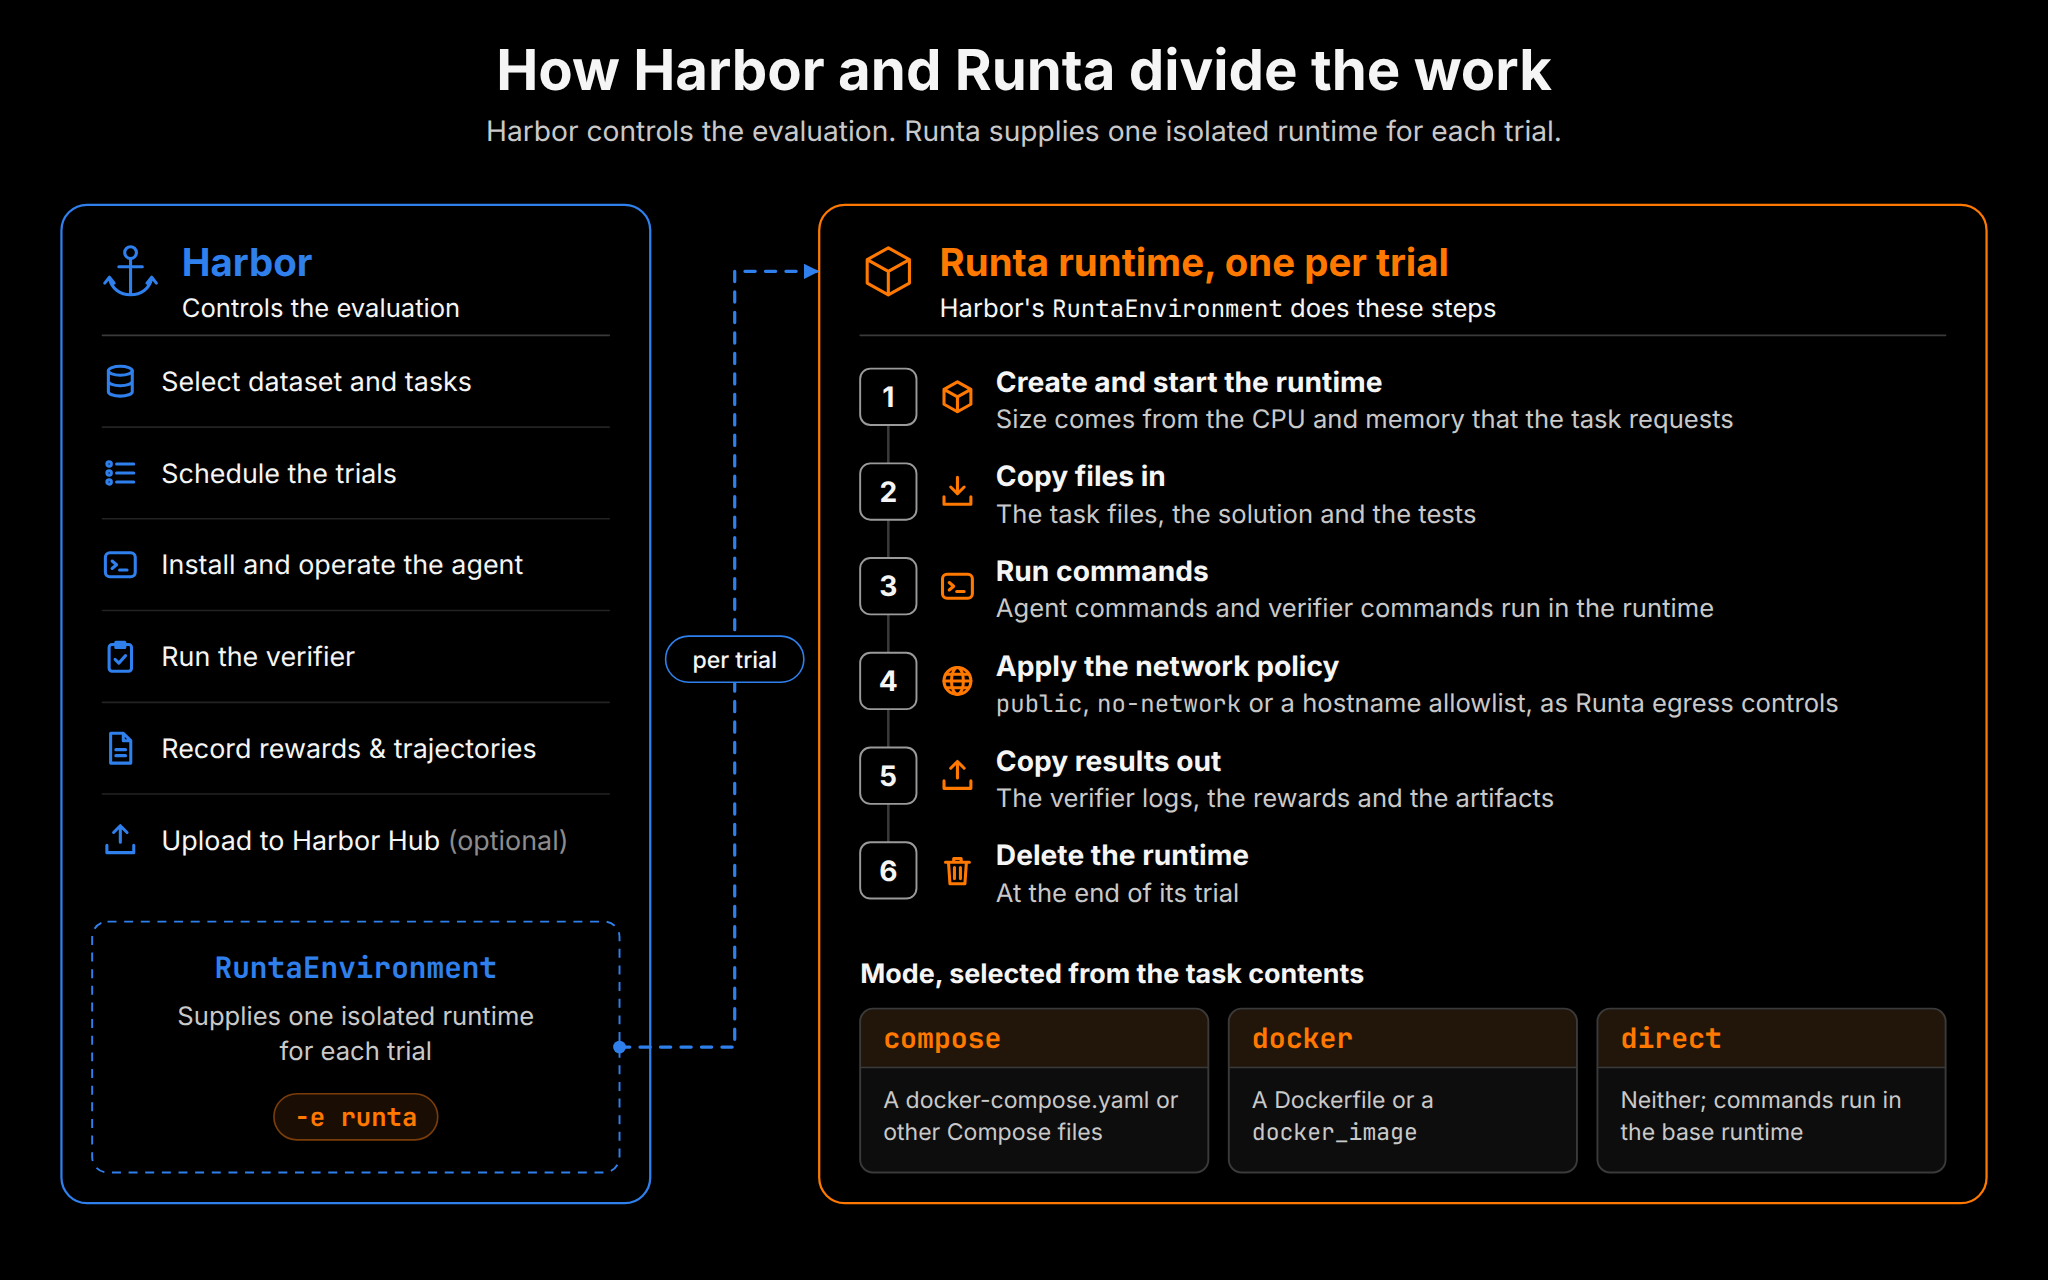 Ảnh: Hacker News
Mỗi model có một harness tối ưu riêng
Kết quả cho thấy không có harness nào thống trị mọi model. Với mỗi model, harness có "giá trị tốt nhất" (được định nghĩa là chi phí thấp nhất cho mỗi lần vượt qua, trừ khi một harness khác có chi phí cao hơn không quá 30% nhưng tỷ lệ vượt qua cao hơn ít nhất 5 điểm) là khác nhau:
- GLM-5.3: Codex CLI (chi phí mỗi lần vượt qua: $0.803)
- GLM-5.3 Flash: Pi
- DeepSeek-V4.1-Flash-1017: ZCode
- Muse: Oh My Pi
- Kimi-K3: Alma
Sự thay đổi thứ hạng chi phí giữa các model là rất lớn. Ví dụ, Codex CLI rẻ nhất với GLM-5.3 nhưng tụt xuống hạng 16 với Kimi-K3. Trung bình, một harness thay đổi 11 trong 22 vị trí khi đổi model. Điều này cho thấy việc chọn harness nên được thực hiện cùng lúc với việc chọn model.
Chi phí không tỷ lệ thuận với tỷ lệ vượt qua
Một phát hiện quan trọng khác: chi phí cao hơn không đồng nghĩa với tỷ lệ vượt qua cao hơn. Với mỗi model, tương quan hạng giữa chi phí mỗi tác vụ và tỷ lệ vượt qua dao động từ -0.39 đến +0.22, tức là gần như không có mối liên hệ. Harness có tỷ lệ vượt qua cao nhất thường chỉ đứng thứ 5 đến 20 trong 22 về chi phí. Với 4 trong 5 model, harness đắt nhất tính theo chi phí mỗi lần vượt qua lại có tỷ lệ vượt qua thấp hơn harness rẻ nhất.
Khi cố định model, sự khác biệt chi phí giữa các harness là đáng kể: harness đắt nhất có thể tốn gấp 1,8 đến 5,0 lần so với rẻ nhất cho cùng một tác vụ. Ví dụ với DeepSeek, Cline CLI tốn gấp 5 lần OpenCode v1 nhưng chỉ đạt tỷ lệ vượt qua cao hơn 2 điểm. Phân tích phương sai cho thấy model giải thích 92,8% sự khác biệt về chi phí, trong khi harness chỉ giải thích 2,3%; phần còn lại (4,9%) đến từ sự tương tác giữa cặp harness-model và nhiễu.
Nguồn gốc chi phí: bước lặp và thất bại
Nhóm nghiên cứu đã phân tích các yếu tố ảnh hưởng đến chi phí và phát hiện rằng số bước lặp (steps) là yếu tố chính, không phải kích thước prompt, số lượng công cụ hay tỷ lệ cache hit. Tương quan hạng giữa số bước trên mỗi lần vượt qua và chi phí là +0.51 (p = 0.015), trong khi các yếu tố khác gần như không có tương quan. Mỗi bước lặp gửi lại toàn bộ ngữ cảnh, khiến một lần thử trung bình sử dụng từ 2,0 đến 4,8 triệu token đầu vào.
Đáng chú ý, 64,5% chi phí suy luận (theo giá niêm yết) đến từ các lần chạy không vượt qua: 52,7% từ thất bại và 11,8% từ hết thời gian. Trong số các lần thất bại, khoảng 3/4 kết thúc bằng một câu trả lời tự tin thay vì hết thời gian, cho thấy các agent thường không nhận ra chúng chưa hoàn thành nhiệm vụ.
Điểm chung của các harness tối ưu
Qua phân tích các harness có giá trị tốt nhất, nhóm tác giả quan sát thấy ba điểm chung (lưu ý đây chỉ là quan sát, chưa được kiểm chứng):
- Một công cụ shell làm phần lớn công việc: Các harness này tập trung 61% đến 93% lệnh gọi công cụ vào một shell tool duy nhất.
- Mỗi yêu cầu chỉ thêm vào yêu cầu trước: Ngữ cảnh không thay đổi phần đầu, giúp tận dụng cache tốt (91,1% đến 94,0% token đầu vào được đọc từ cache).
- Không dùng subagent và hầu như không tóm tắt: Trong số 5 harness tốt nhất, chỉ Codex CLI có tóm tắt (ở 8 lần thử), và mỗi harness chỉ dùng subagent tối đa 6 lần.
Tuy nhiên, các harness này cũng có điểm yếu chung: các lần chạy thất bại thường kết thúc với câu trả lời tự tin, và rất ít khi nói rằng công việc chưa hoàn thành. Một kiểm tra trước khi dừng có thể tiết kiệm chi phí, nhưng nhóm chưa thử nghiệm điều này.
Vì sao đáng quan tâm với lập trình viên Việt Nam
Với cộng đồng lập trình viên Việt Nam đang ngày càng sử dụng các coding agent như Cline, OpenCode, hay các harness khác, kết quả này có ý nghĩa thực tiễn:
- Chi phí: Nếu bạn đang dùng một harness với một model cụ thể, việc đổi model có thể khiến chi phí tăng đột biến. Hãy kiểm tra lại harness khi đổi model.
- Hiệu quả: Đừng cho rằng harness đắt tiền hơn sẽ tốt hơn. Thử nghiệm trên tập tác vụ riêng của bạn là cách duy nhất để biết.
- Tối ưu: Số bước lặp là yếu tố then chốt. Hãy xem xét cách harness của bạn quản lý ngữ cảnh và lặp lại các bước.
Ai nên thử và cách thử nhanh
Nếu bạn đang phát triển hoặc sử dụng coding agent, bạn có thể:
- Truy cập FrontierHarness dashboard để xem dữ liệu chi tiết.
- Chạy benchmark trên tập tác vụ riêng của bạn với các harness ứng viên và model bạn định dùng.
- Chú ý đến số bước lặp và tỷ lệ cache hit khi so sánh chi phí.
Lưu ý và hạn chế
Nghiên cứu này có một số hạn chế cần lưu ý:
- Chỉ sử dụng model mã nguồn mở và một nhà cung cấp (Baseten). Kết quả có thể khác với model đóng hoặc nhà cung cấp khác.
- Giá và cache được tính theo Baseten; nhà cung cấp khác có thể thay đổi thứ hạng chi phí.
- Các quan sát về điểm chung của harness tốt nhất chưa được kiểm chứng bằng thử nghiệm.
- Bài viết gốc được đăng trên blog của Runta, công ty cung cấp dịch vụ runtime cho agent, nên độc giả có thể cân nhắc yếu tố lợi ích khi đọc kết quả.
Kết luận
FrontierHarness Eval v1.1 cung cấp dữ liệu quy mô lớn cho thấy việc chọn harness nên đi cùng với việc chọn model. Chi phí phần lớn do model quyết định, nhưng harness có thể tạo ra sự khác biệt đáng kể (gấp 1,8 đến 5 lần). Đặc biệt, phần lớn chi phí đổ vào các lần chạy thất bại, cho thấy cần cải thiện khả năng tự đánh giá của agent. Đối với lập trình viên, lời khuyên là hãy thử nghiệm trên tập tác vụ riêng và đừng chỉ nhìn vào giá.
Nguồn: Hacker News
Nguồn tham khảo: Hacker News
Bài viết liên quan
AI cho lập trình viên8 phút đọc
awesome-mcp-servers: danh bạ MCP server gần 100 nghìn sao trên GitHub
Repo punkpeye/awesome-mcp-servers gom các MCP server do cộng đồng đóng góp, đạt 97 nghìn sao. Cách dùng hiệu quả và những rủi ro bảo mật cần lưu ý.
AI cho lập trình viên8 phút đọc
Gemini 4 Carbon dẫn đầu Intelligence Index v5, chỉ xếp sau Opus 5.5 về coding
Gemini 4 Carbon đạt 59 điểm, đứng đầu Artificial Analysis Intelligence Index v5 và chỉ kém Claude Opus 5.5 ba điểm ở chỉ số coding agent.
AI cho lập trình viên11 phút đọc
team-solve: 5 Qwen3.8-27B đấu Fable 5 trên LiveCodeBench Hard
Workflow đa tác tử team-solve của Memdoor dùng 5 vai Qwen3.8-27B, đạt trung bình 9,8/10 trên 10 bài LiveCodeBench Hard, so với 8,0 của Fable 5.
Bình luận
Đang tải bình luận…