
Gemini 4 Carbon dẫn đầu Intelligence Index v5, chỉ xếp sau Opus 5.5 về coding
Gemini 4 Carbon đạt 59 điểm, đứng đầu Artificial Analysis Intelligence Index v5 và chỉ kém Claude Opus 5.5 ba điểm ở chỉ số coding agent.
Artificial Analysis vừa công bố kết quả đánh giá Gemini 4 Carbon, mô hình mới nhất của Google. Mô hình này đứng số 1 trên Artificial Analysis Intelligence Index v5 và xếp thứ hai, chỉ sau Claude Opus 5.5, trên Coding Agent Index. Bài viết lên trang nhất Hacker News với 288 điểm và 222 bình luận (tính đến ngày 29/10/2026).
Với lập trình viên, phần đáng xem nhất không phải vị trí số 1 tổng thể. Đáng xem hơn là việc Google, vốn thường bị đánh giá yếu hơn đối thủ ở mảng coding agent, giờ đã bám sát nhóm dẫn đầu. Chi phí mỗi tác vụ cũng thấp hơn đáng kể so với Opus 5.5.
Có gì mới: điểm số tổng thể
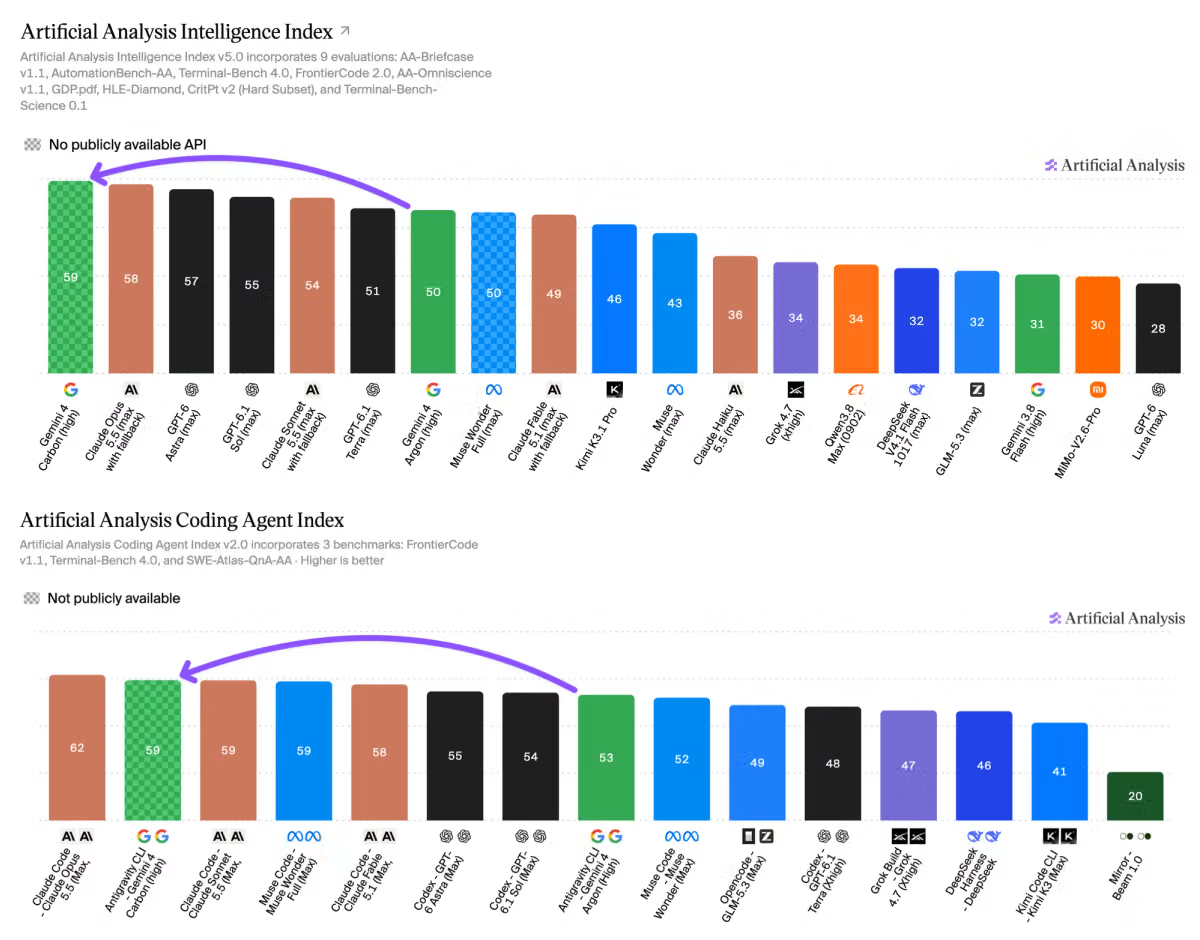
Theo Artificial Analysis, Gemini 4 Carbon ở mức reasoning high đạt 59 điểm trên Intelligence Index v5. Mô hình dẫn đầu ở 4 trên 9 bài đánh giá cấu thành chỉ số:
- HLE-Diamond
- Terminal-Bench-Science
- AA-Omniscience
- AutomationBench-AA
Điểm mạnh tập trung ở suy luận phức tạp, kiến thức và các tác vụ khoa học. Ở coding và knowledge work, Carbon tiến bộ rõ so với các mô hình Gemini trước nhưng chưa dẫn đầu.
Intelligence Index v5 cũng là phiên bản rất mới, được Artificial Analysis công bố ngày 27/10/2026. Phiên bản này có 2 benchmark mới, 3 benchmark được nâng cấp, và lần đầu tiên phần lớn chỉ số dựa trên bộ dữ liệu riêng (private datasets). Điểm v5 vì vậy không nên so trực tiếp với điểm của các phiên bản index trước.
 Ảnh: Artificial Analysis (Hacker News)
Coding agent: chỉ kém Claude Opus 5.5 ba điểm
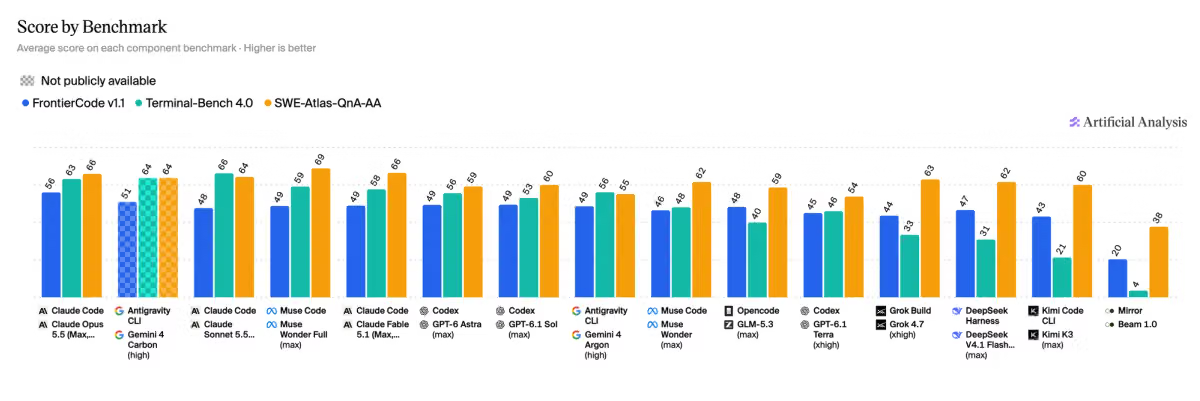
Đây là phần đáng chú ý nhất với độc giả chuyên mục. Khi chạy qua Antigravity CLI, Gemini 4 Carbon (high) đạt 59 điểm trên Coding Agent Index. Mức này kém 3 điểm so với tổ hợp Claude Code + Claude Opus 5.5 (max) ở 62 điểm.
Ở từng benchmark thành phần:
- Terminal-Bench 4.0: Carbon đạt 64%, xếp thứ hai.
- FrontierCode v1.1: Carbon đạt 51%, xếp thứ hai sau Claude Opus 5.5 (max) với 56%.
Artificial Analysis nhận xét Google trước đây thường kém ở mảng này, nên bước tiến lần này khá nổi bật. Lưu ý là Coding Agent Index đánh giá cặp agent + mô hình: Carbon chạy trong Antigravity CLI, còn Opus 5.5 chạy trong Claude Code. Kết quả vì thế phản ánh cả chất lượng harness lẫn bản thân mô hình.
 Ảnh: Artificial Analysis (Hacker News)
Cũng trong tuần này, Artificial Analysis đăng bài về GitHub Copilot Fusion, tính năng điều phối giữa mô hình của Anthropic và OpenAI. Theo đơn vị này, Copilot Fusion kém Opus 5.5 trong Claude Code 2 điểm trên Coding Agent Index nhưng chi phí mỗi tác vụ chỉ bằng một nửa. Cuộc đua coding agent vì thế không chỉ xoay quanh điểm số mà ngày càng tính đến chi phí.
Knowledge work kiểu agent: tiến bộ nhưng chưa dẫn đầu
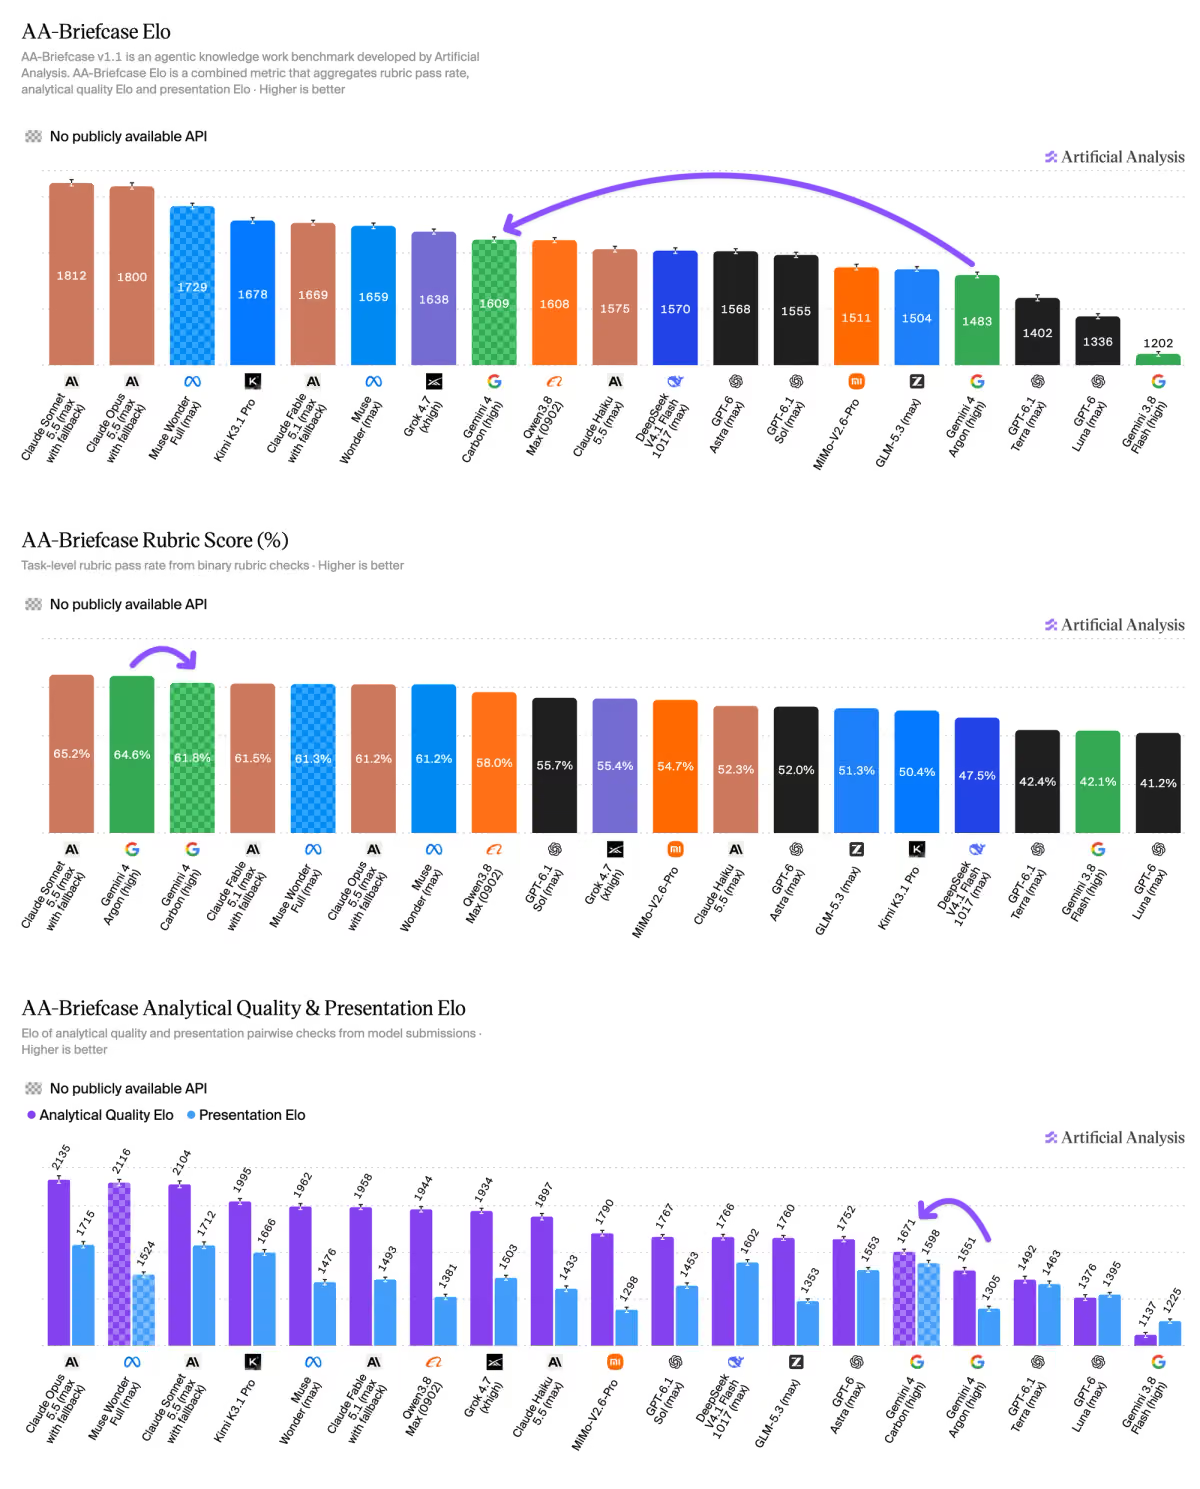
Trên AA-Briefcase, bài đánh giá knowledge work dạng agent tính theo Elo, Gemini 4 Carbon (high) đạt 1609 Elo. Con số này tăng 126 điểm so với Gemini 4 Argon (high, 1483), nhưng vẫn xếp sau:
- Grok 4.7 (xhigh): 1638
- Muse Wonder (max): 1659
- Kimi K3.1 Pro: 1678
Mức tăng lớn nhất nằm ở hạng mục Presentation: tăng 293 Elo, lên 1598. Hạng mục Analytical Quality tăng 120 điểm, lên 1671.
 Ảnh: Artificial Analysis (Hacker News)
Chi phí mỗi tác vụ: rẻ hơn Opus 5.5 khoảng 23%
Artificial Analysis tính chi phí theo giá tiêu chuẩn (không tính khuyến mãi):
- Gemini 4 Carbon tốn $7,76 cho mỗi tác vụ của Intelligence Index.
- Claude Opus 5.5 (max) tốn $10,04, tức Carbon rẻ hơn khoảng 23%.
- GPT-6 Astra (max) tốn $6,25, tức Carbon đắt hơn khoảng 1,2 lần.
Carbon dùng trung bình 123k output tokens mỗi tác vụ, ít hơn 29% so với Opus 5.5 (max, 173k). Cùng mức giá tiêu chuẩn $4/$20, chi phí mỗi tác vụ của Carbon gần như ngang Gemini 4 Argon ($7,68), trong khi điểm Intelligence Index cao hơn 9 điểm.
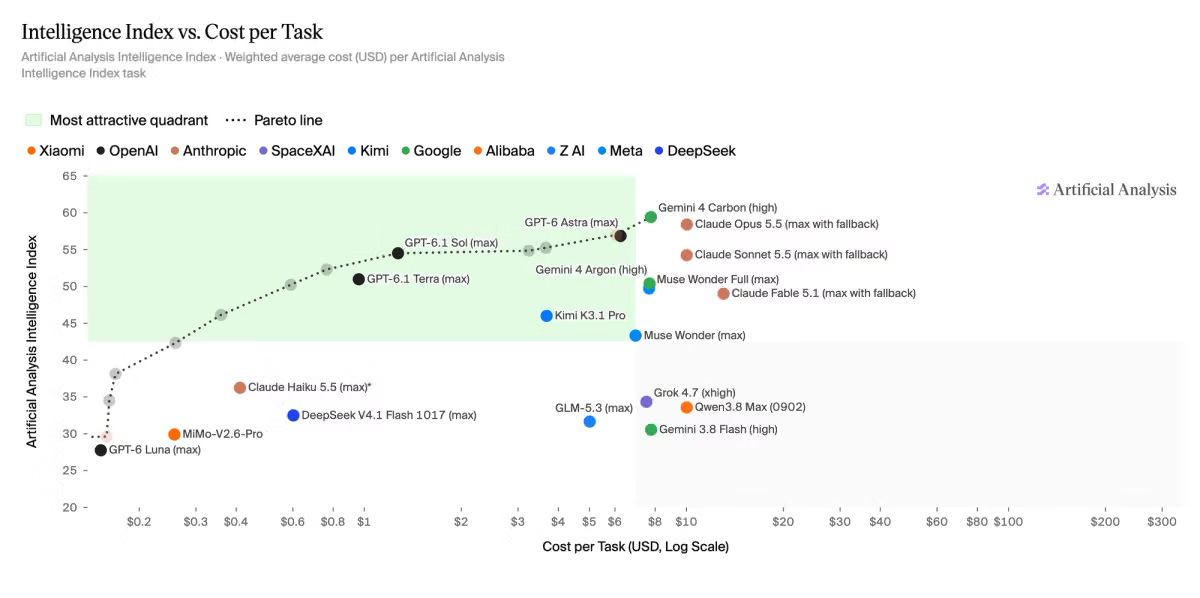 Ảnh: Artificial Analysis (Hacker News)
Kiến thức và tỷ lệ hallucination
Trên AA-Omniscience v1.1, phiên bản vừa được cập nhật, Gemini 4 Carbon đạt 54 điểm. Mức này cao hơn Claude Opus 5.5 (max) 6 điểm (48) và cao hơn Gemini 4 Argon 8 điểm (46).
Độ chính xác tăng 10 điểm so với Argon, lên 58%. Đổi lại, tỷ lệ hallucination tăng từ 4% lên 11%. Theo Artificial Analysis, 11% vẫn là mức thấp thứ hai trong các mô hình được đo, chỉ sau Argon. Để so sánh, Claude Opus 5.5 (max) và GPT-6 Astra (max) cùng ở mức 50%.
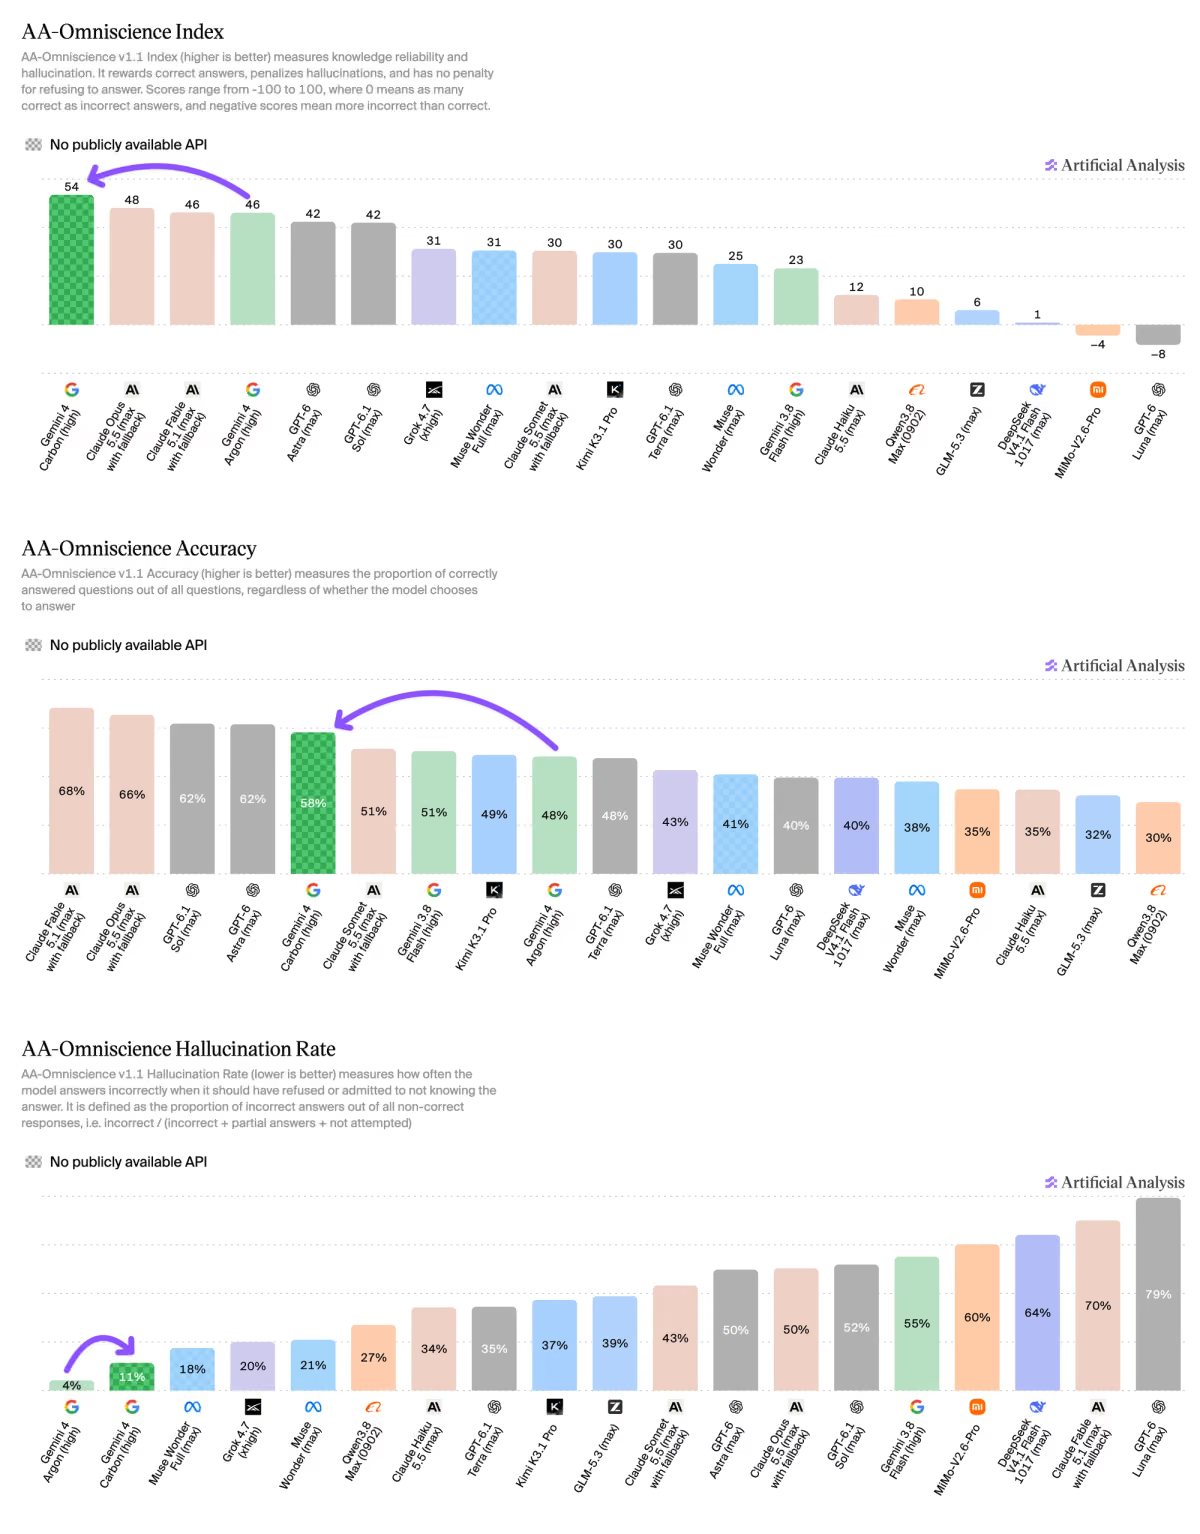 Ảnh: Artificial Analysis (Hacker News)
Thông số chính
- Context window: 1M tokens.
- Đa phương thức: đầu vào gồm văn bản, hình ảnh, video và giọng nói; đầu ra là văn bản.
- Giá tiêu chuẩn: $4 / $20 cho mỗi 1M input/output tokens, bằng giá tiêu chuẩn của Gemini 4 Argon.
- Khuyến mãi ra mắt: giảm 50%, chưa có ngày kết thúc chính thức. Theo tính toán đơn giản, giá hiệu lực tạm thời là $2 / $10.
- Cached input: giảm 95%, tức $0,20 cho mỗi 1M tokens theo giá tiêu chuẩn.
Vì sao đáng quan tâm với lập trình viên Việt Nam
Nhiều team ở Việt Nam đang dùng coding agent hằng ngày, từ startup nhỏ đến công ty outsourcing. Với họ, chi phí API là khoản đáng kể, nhất là khi agent chạy những tác vụ dài và sinh nhiều token. Có vài điểm đáng cân nhắc:
- Thêm một lựa chọn cạnh tranh ở mảng coding agent. Lâu nay Claude gần như là mặc định cho các workflow agent nặng. Một mô hình kém 3 điểm nhưng rẻ hơn khoảng 23% mỗi tác vụ (theo giá tiêu chuẩn) đáng được đưa vào danh sách thử nghiệm.
- Ít output token hơn. Với agent chạy nhiều vòng, việc sinh ít token hơn 29% ảnh hưởng trực tiếp tới hóa đơn và thời gian chờ.
- Context 1M cùng chiết khấu cache 95% phù hợp với các codebase lớn, nơi bạn phải nạp lại cùng một khối ngữ cảnh nhiều lần.
- Hallucination thấp so với mặt bằng chung có ích cho các tác vụ tra cứu tài liệu, API hoặc kiến thức kỹ thuật. Tuy vậy, cần nhớ tỷ lệ này đã tăng so với Argon.
Đây là nhận định của người viết dựa trên số liệu benchmark. Hiệu quả thực tế còn phụ thuộc vào ngôn ngữ, framework và kiểu tác vụ của từng team.
Ai nên quan tâm và chuẩn bị thế nào
Gemini 4 Carbon hiện chỉ được triển khai cho một số người dùng chọn lọc và chưa mở công khai, giống cách Google từng làm với Gemini 4 Argon. Nguồn chưa nêu lịch phát hành rộng rãi, cũng chưa nêu model ID cụ thể trên API.
Trong lúc chờ, bạn có thể chuẩn bị trước:
- Xây bộ đánh giá nội bộ: chọn 20–50 tác vụ thật từ repo của team (fix bug, viết test, refactor) để so các mô hình khi Carbon mở rộng.
- Đo chi phí theo tác vụ, không theo giá token: một mô hình có giá token cao hơn vẫn có thể rẻ hơn nếu sinh ít token hơn. Cách Artificial Analysis tính Cost per Task là một gợi ý hay.
- Tách biến harness: nếu so Gemini với Claude, nên thử cả trong Antigravity CLI lẫn trong các agent trung lập, để biết điểm khác biệt đến từ mô hình hay từ công cụ.
- Tính đến khả năng hết khuyến mãi: mức giảm 50% chưa có ngày kết thúc, nên dự toán ngân sách theo giá tiêu chuẩn $4/$20 để tránh bất ngờ.
Lưu ý và hạn chế
- Chưa thể tự kiểm chứng: mô hình chưa công khai, nên hiện chỉ có số liệu từ Artificial Analysis.
- Index mới, dữ liệu riêng: Intelligence Index v5 vừa ra mắt một ngày trước bài đánh giá và phần lớn dựa trên dataset riêng. Cách này giúp hạn chế việc mô hình "học tủ" benchmark, nhưng cộng đồng cũng khó tự tái lập kết quả.
- Benchmark khác công việc thật: điểm số tổng hợp không thay được việc thử trên codebase của bạn.
- Hallucination tăng: từ 4% lên 11% so với Argon. Vẫn thấp so với đối thủ, nhưng đây là xu hướng nên theo dõi.
- Chưa dẫn đầu mọi mảng: ở coding và knowledge work dạng agent, Carbon vẫn xếp sau một số mô hình khác.
- Bài gốc đăng trên trang của Artificial Analysis, một đơn vị chuyên cung cấp dịch vụ benchmark và phân tích mô hình AI. Độc giả nên đọc kết quả với hiểu biết đó.
Kết
Gemini 4 Carbon là bước tiến rõ rệt của Google, nhất là ở mảng coding agent vốn là điểm yếu nhiều năm của hãng. Theo Artificial Analysis, mô hình đạt hiệu năng sát Claude Opus 5.5 với chi phí mỗi tác vụ thấp hơn. Khi Carbon mở rộng cho nhiều người dùng hơn, đây sẽ là ứng viên đáng đưa vào bộ thử nghiệm của các team đang tối ưu chi phí coding agent.
Nguồn tham khảo: Artificial Analysis (Hacker News)
Bài viết liên quan
AI cho lập trình viên11 phút đọc
team-solve: 5 Qwen3.8-27B đấu Fable 5 trên LiveCodeBench Hard
Workflow đa tác tử team-solve của Memdoor dùng 5 vai Qwen3.8-27B, đạt trung bình 9,8/10 trên 10 bài LiveCodeBench Hard, so với 8,0 của Fable 5.
AI cho lập trình viên17 phút đọc
OpenAI và Anthropic tặng credit API cho gói ChatGPT, Claude trả phí
OpenAI vừa áp dụng chính sách giống Anthropic: gói trả phí 100, 200, 500 USD/tháng được cấp credit API tương đương, dùng cho tổ chức API của bạn.
AI cho lập trình viên7 phút đọc
LlamaFactory: tinh chỉnh 100+ LLM và VLM trong một repo
LlamaFactory gộp pre-training, SFT, DPO, PPO, LoRA/QLoRA cho hơn 100 mô hình ngôn ngữ và đa phương thức vào một CLI và Web UI, giấy phép Apache-2.0.
Bình luận
Đang tải bình luận…