Claude và GPT: 180 lần gọi để biết mô hình nào đáng tiền
Một kỹ sư Việt chạy 180 lần gọi API trên ba mô hình Claude và GPT, phát hiện cùng giá niêm yết nhưng hóa đơn chênh 5,6 lần và độ chính xác khác rõ rệt.
Một buổi chiều, 180 lần gọi API
Khi chuyển đổi giữa các mô hình AI, câu hỏi quen thuộc nhất là "cái nào tốt hơn?". Nhưng câu trả lời thường chỉ dựa trên vài lần thử ngẫu nhiên, đủ để thấy mô hình trông ổn hoặc trông tệ, mà không đủ để biết nó ổn hay tệ một cách có hệ thống. Tác giả crboluo trên Viblo đã làm một thí nghiệm nhỏ nhưng kỹ lưỡng: 12 bài kiểm tra, mỗi bài gửi 5 lần cho 3 mô hình, tổng cộng 180 lần gọi trong một buổi chiều, với chi phí mỗi lần từ 0,0033 đến 0,0265 USD.
Điều đáng chú ý không nằm ở việc mô hình nào "thắng", mà ở cách đo và những khác biệt mà một lần thử duy nhất không thể phát hiện: lỗi ngẫu nhiên so với lỗi có hệ thống, chi phí thực tế so với giá niêm yết, và độ trễ khi đưa vào vận hành thật.
Vì sao một lần thử là chưa đủ
Theo tác giả, nếu chỉ gọi một lần, bạn không phân biệt được hai tình huống rất khác nhau: mô hình gặp xui trong lần đó, hay mô hình có tật cố hữu. Với lỗi ngẫu nhiên, cách xử lý là gọi lại. Với lỗi có hệ thống, cách xử lý là đổi mô hình hoặc thêm lớp kiểm tra. Hai hướng này chênh nhau rất nhiều về công sức và tiền bạc, nên đoán sai sẽ tốn kém.
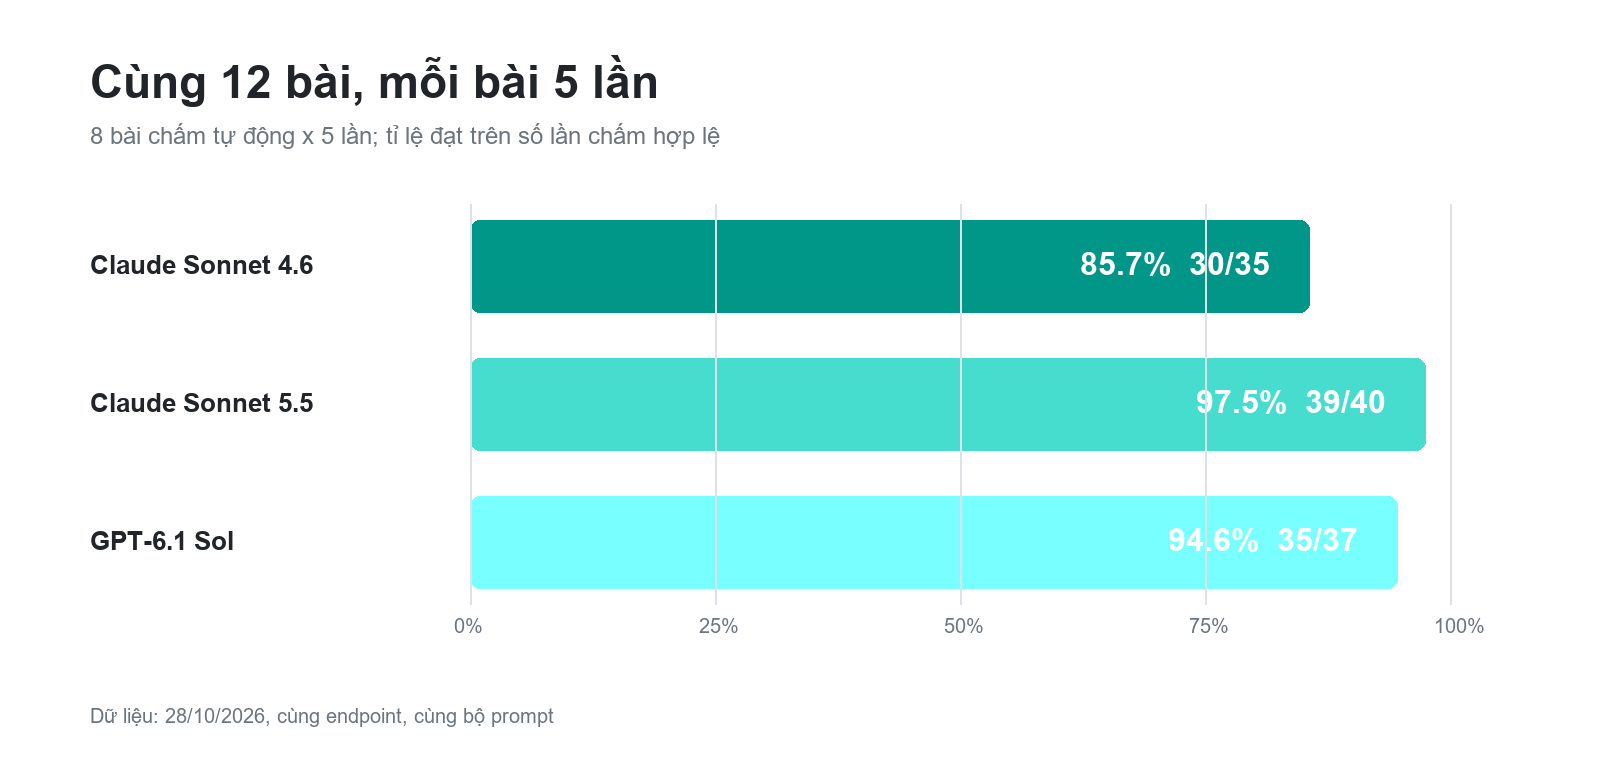
Năm lần mỗi bài được chọn vì đủ để nhìn thấy cùng một lỗi lặp lại hai lần, mà vẫn kịp hoàn thành trong một buổi. Mười hai bài chia làm hai nhóm: tám bài có đáp án rõ ràng nên chấm tự động được (một bài tính, một bài xác suất, một bài định nghĩa có giới hạn ký tự, vài bài về định dạng đầu ra), và bốn bài viết lại mã/viết lại văn phải đọc bằng mắt nên được để ngoài tỉ lệ đạt.
 Ảnh: Viblo
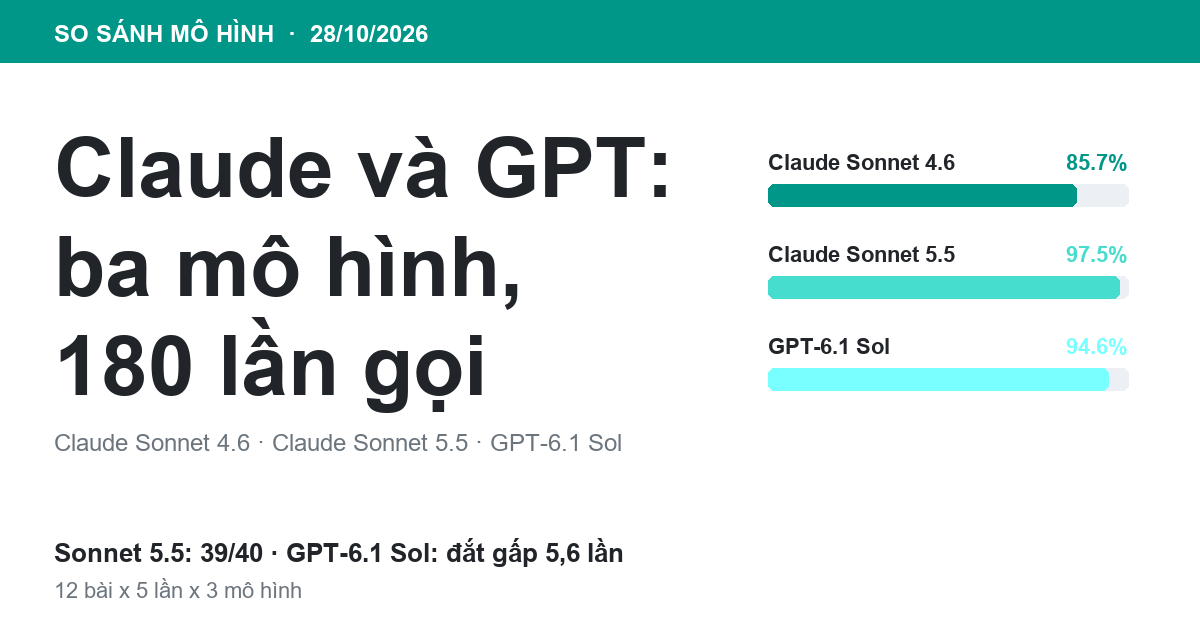
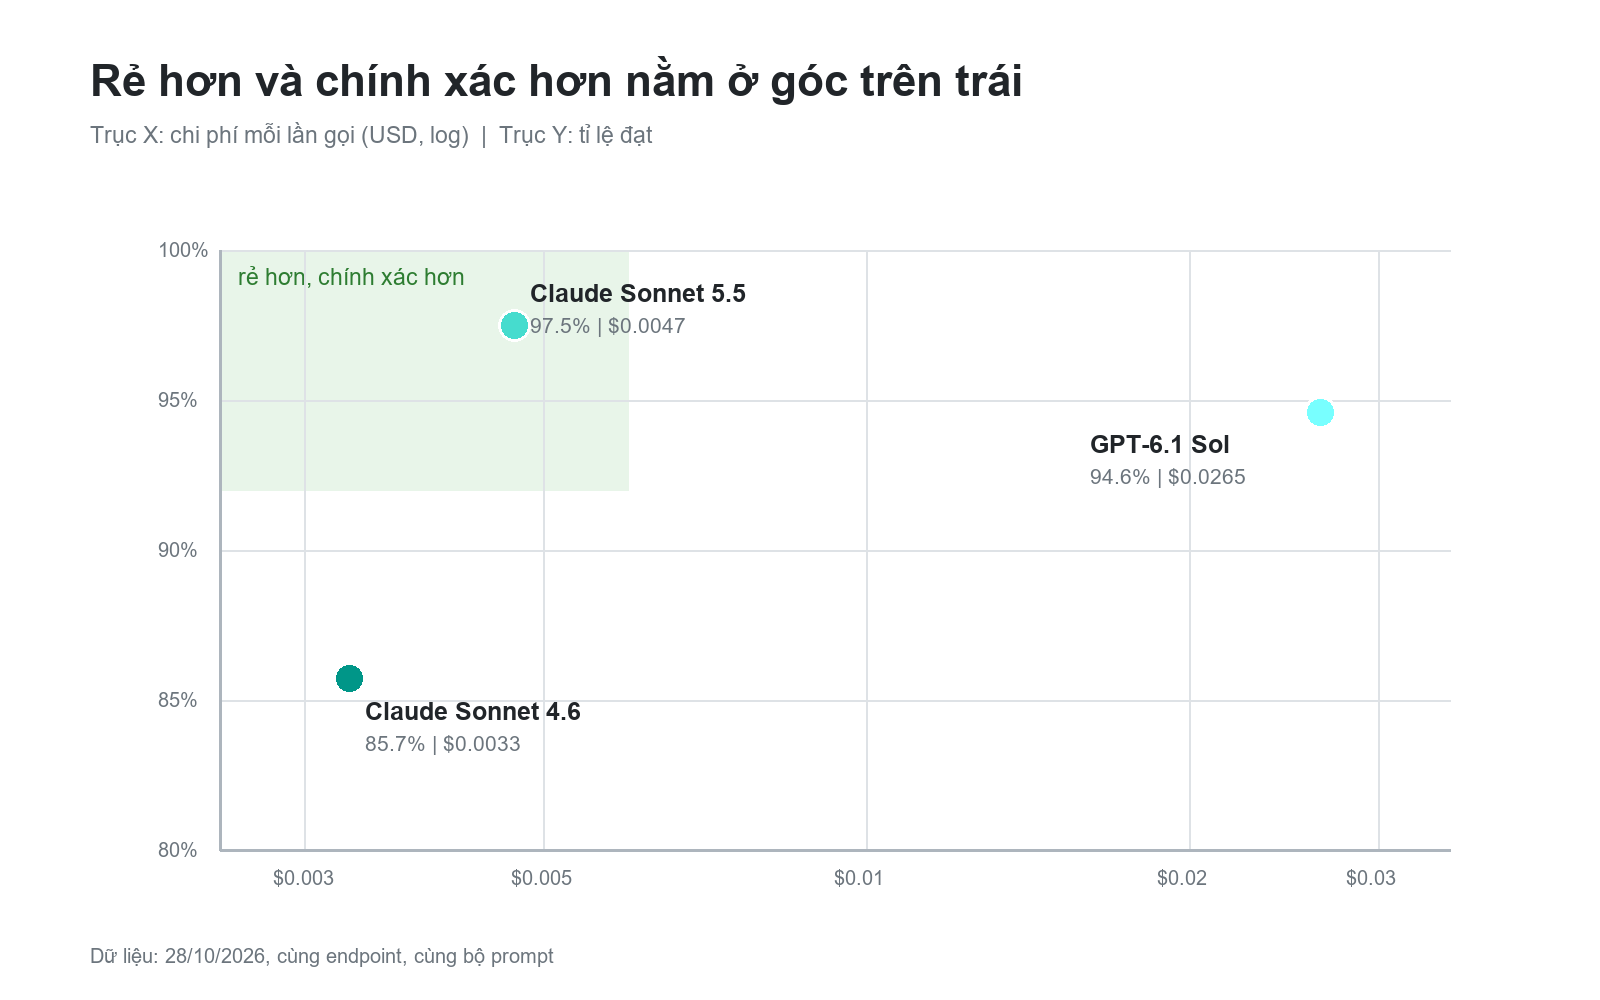
Kết quả tổng hợp: Claude Sonnet 4.6 đạt 30/35, Claude Sonnet 5.5 đạt 39/40, GPT-6.1 Sol đạt 35/37. Mẫu số khác nhau vì 13 trong 180 lần gọi bị lỗi mạng và bị loại. Tác giả nhấn mạnh: nếu ép tất cả về mẫu 40 thì bạn đang so sánh đường truyền, không phải so sánh mô hình.
 Ảnh: Viblo
Ba khác biệt đáng chú ý
Giới hạn 60 ký tự: khi "nói cho đủ" thành lỗi hàng loạt
Bài kiểm tra yêu cầu giải thích MoE trong không quá 60 ký tự và không dùng chữ "chuyên gia". Claude Sonnet 4.6 trả về 65 ký tự, vượt năm ký tự ở các cụm bổ nghĩa. Gửi thêm bốn lần, độ dài lần lượt là 65, 62, 68, 66 và 70 — không lần nào xuống dưới 60. Theo tác giả, đây không phải lỗi đếm mà là mô hình đặt "nói cho đủ" lên trước "giữ đúng giới hạn". Khi viết bài, đó là điểm cộng; khi chạy hàng loạt, đó là hàng lỗi phải sửa tay, và công sửa tay đắt hơn tiền gọi API.
Sai một lần trong năm: nhiễu hay tín hiệu?
Ở bài xác suất (lấy ba số khác nhau từ 1 đến 5, tính xác suất tổng là số chẵn, đáp án 3/5), Claude Sonnet 5.5 đúng bốn trên năm lần. Lần sai, mô hình đếm nhầm tổ hợp: đáng lẽ là "hai lẻ một chẵn" thì nó làm "một lẻ hai chẵn", khiến số cách và đáp án cùng giảm một nửa. Tác giả chỉ ra đây chính là lý do phải lặp: nếu chỉ xem một lần, mô hình hoặc trông hoàn hảo, hoặc trông không dùng được. Nhìn cả năm lần thì nó là 39/40, sai đúng một bài có đáp án rõ ràng — và cách xử lý là gọi lại.
Cùng giá niêm yết, hóa đơn gấp 5,6 lần
Claude Sonnet 5.5 và GPT-6.1 Sol có cùng giá niêm yết: 2 USD mỗi triệu token đầu vào, 10 USD mỗi triệu token đầu ra. Nhưng chi phí thực tế mỗi lần gọi là 0,0047 USD và 0,0265 USD — chênh 5,6 lần. Theo tác giả, chênh lệch không nằm ở đơn giá mà ở lượng tiêu thụ cho mỗi bài: Sol xử lý nhiều bước hơn giữa lúc nhận câu hỏi và lúc trả lời. Khoản tiền thêm đó cũng không mua được độ chính xác: ở bài hình elip (đáp án 16/5), Sol chỉ trả về 4/5 trong hai trên năm lần, trong khi hai mô hình Claude làm đúng cả năm lần.
 Ảnh: Viblo
Bài toán gần thực tế: 20 ticket, 100 ô dữ liệu
Mười hai bài nhỏ là bài kiểm tra, không phải công việc. Tác giả chạy thêm một dạng gần thực tế hơn: 20 ticket hỗ trợ, mỗi ticket bóc ra 5 trường, tổng cộng 100 ô dữ liệu. Cả ba mô hình điền đúng cả 100 ô — độ chính xác không tách được mô hình nào. Thời gian thì có: Sonnet 5.5 mất 7,5 giây, GPT-6.1 Sol 29,3 giây, Sonnet 4.6 37,9 giây. Nửa phút mỗi lần nghe không đáng kể, nhưng ở quy mô 10.000 lần một ngày, chênh lệch lên tới hơn 84 giờ, tức hơn ba ngày chờ đợi hoặc trả tiền.
Vì sao đáng quan tâm với đội kỹ thuật Việt Nam
Phần lớn đội sản phẩm ở Việt Nam đang tích hợp LLM vào quy trình thật: bóc tách dữ liệu từ ticket, sinh nội dung hàng loạt, trả kết quả có cấu trúc cho API. Trong những bối cảnh đó, ba con số quan trọng nhất không phải là điểm benchmark công khai, mà là tỉ lệ đạt trên dữ liệu của chính mình, độ trễ trung vị, và chi phí thực trả mỗi lần gọi.
Bài viết của crboluo đưa ra một phương pháp luận rất đáng bắt chước: lấy ba việc làm hằng ngày, mỗi việc một prompt cố định, gửi năm lần, rồi ghi lại bốn thứ — số lần đúng, bài nào sai, thời gian trung vị, và chi phí mỗi lần gọi. Bốn con số này đủ để quyết định, hơn mọi bảng xếp hạng chung. Với các đội đang cân nhắc chi phí API hằng tháng, việc hiểu rằng giá niêm yết bằng nhau không đồng nghĩa hóa đơn bằng nhau là bài học trực tiếp: lượng token tiêu thụ cho mỗi tác vụ mới là biến số quyết định.
Một điểm nữa cũng hữu ích cho ai đang thiết kế pipeline: nếu đầu ra cần tuân thủ giới hạn cứng về độ dài hoặc định dạng, hãy chọn mô hình ít vượt rào thay vì mô hình "viết hay". Tác giả khuyến nghị Claude Sonnet 5.5 cho các việc có giới hạn cứng — viết hàng loạt, đầu ra có cấu trúc, dữ liệu trả về cho API — vì không lần nào vượt giới hạn, độ trễ trung vị ngắn nhất và chi phí mỗi lần gọi thấp nhất trong ba. Với việc viết một lần rồi có người sửa, Claude Sonnet 4.6 vẫn hợp lý vì câu trả lời dài và đầy đủ hơn là nguyên liệu, không phải lỗi.
Ai nên thử và cách thử nhanh
Cách làm này phù hợp với kỹ sư tích hợp LLM, đội vận hành có chi phí API đáng kể, và cả những ai đang cân nhắc đổi mô hình giữa các nhà cung cấp. Không cần đúng mười hai bài như trên; quy trình tối thiểu gồm:
- Chọn ba tác vụ đại diện cho công việc hằng ngày, mỗi tác vụ viết một prompt cố định.
- Gửi mỗi prompt năm lần cho từng mô hình ứng viên, ghi lại kết quả từng lần.
- Đo bốn chỉ số: số lần đúng, danh sách lần sai, thời gian trung vị, chi phí mỗi lần gọi.
- Chỉ đổi mô hình khi khác biệt đủ lớn — tác giả lưu ý nếu chỉ chênh một hai lần đúng trên tổng ba mươi thì đó là nhiễu, không phải tín hiệu.
Về giới hạn ký tự, đừng chỉ dựa vào prompt. Nếu API cho phép đặt max_tokens, hãy đặt, nhưng cần biết rằng nó cắt chứ không dạy mô hình viết ngắn — câu bị cắt vẫn phải sửa tay, chỉ là kiểu sửa khác.
Những gì chưa được kiểm tra
Tác giả nêu rõ giới hạn của thí nghiệm: toàn bộ số liệu là văn bản một lượt, đầu vào ngắn. Ngữ cảnh dài, hội thoại nhiều lượt, gọi công cụ và hiểu hình ảnh đều chưa thử. Ba mô hình có cửa sổ ngữ cảnh khác nhau — 200K, 1M và 922K token — nhưng đó là thông số, không phải kết quả đo. Bốn bài do người chấm không nằm trong tỉ lệ đạt, và 13 lần gọi lỗi mạng đã bị loại. Giá được đọc từ danh mục mô hình ngày 28/10/2026, hóa đơn thực tế phụ thuộc mức dùng.
Đây là bài chia sẻ trải nghiệm cá nhân trên Viblo, không phải đánh giá độc lập có kiểm chứng chéo, nên độc giả nên xem các con số như một mẫu tham khảo và tự lặp lại trên dữ liệu của mình trước khi quyết định.
Kết
Thông điệp cốt lõi của thí nghiệm khá gọn: một lần gọi không nói được gì, vài lần gọi nói được nhiều hơn bạn tưởng. Với chi phí chỉ vài đô-la cho 180 lần gọi, việc đo trên chính dữ liệu của mình rẻ hơn nhiều so với việc chọn sai mô hình rồi sửa hậu quả trong production.
Nguồn: Viblo
Nguồn tham khảo: Viblo
Bài viết liên quan

Công nghệ Việt Nam7 phút đọc
Việt Nam diễn tập an ninh mạng quốc gia 2026: 10 đội, 43 thử thách CTF
90 cán bộ an ninh mạng chia thành 10 đội diễn tập 7,5 giờ phòng thủ và điều tra tấn công vào hệ thống một tổ chức tài chính, chấm điểm qua 43 thử thách CTF.
Công nghệ Việt Nam9 phút đọc
Apple và Việt Nam: Đề nghị nâng vị thế trong chuỗi cung ứng
Phó Thủ tướng Thường trực Phạm Gia Túc đề nghị Apple mở rộng chuỗi cung ứng tại Việt Nam, hỗ trợ nhà cung cấp nội địa và đào tạo kỹ sư công nghệ cao.

Công nghệ Việt Nam7 phút đọc
Việt Nam - Lào nghiên cứu công nhận chéo chữ ký số
NEAC và LANIC đang xúc tiến thí điểm công nhận lẫn nhau về chữ ký số, trước mắt trong hải quan và xuất nhập khẩu, hướng tới mở rộng trong ASEAN.
Bình luận
Đang tải bình luận…